Empresa
IBM Research
IBM Research es el laboratorio de investigación de IBM, que publica benchmarks, métodos de evaluación y sistemas de agentes de IA orientados a entornos empresariales como IT, operaciones industriales, migración de software y atención al cliente. Su producción reciente se difunde sobre todo a través de publicaciones en Hugging Face y gira en torno a la evaluación rigurosa y la mejora de la fiabilidad de los agentes.
IA para hoy ha analizado 12 noticias sobre IBM Research, procedentes de 1 medio distinto. En los últimos siete días han sido 2, frente a las 0 de la semana anterior. La fiabilidad media de esa cobertura es de 4,3 sobre 5, medida con las reglas de nuestro método. Las áreas de impacto que más se repiten son Operaciones, IT, Automatización. Aparece en 8 historias en seguimiento.
Evolución en 16 semanas
El momentum semanal se estima con la misma fórmula que el momentum actual: volumen, aceleración respecto a la semana anterior, diversidad de fuentes e impacto.
Análisis Qué significa para una empresa
- Oportunidades
- Los benchmarks y métodos publicados (ITBench, VAKRA, AssetOpsBench, ScarfBench) pueden servir para evaluar agentes antes de desplegarlos en procesos internos. ALTK-Evolve muestra que es posible mejorar la consistencia y reducir costes de tokens sin reentrenar modelos, lo que abre opciones de optimización de agentes ya existentes.
- Riesgos
- Las cifras proceden en gran parte de la propia IBM y en varios casos no han sido verificadas por terceros. Los resultados publicados indican que los agentes aún fallan con frecuencia en tareas empresariales complejas (por ejemplo, 14% de éxito en ITBench o ningún modelo por encima del umbral de producción en AssetOpsBench), por lo que existe riesgo de sobreestimar su madurez.
- Qué debería hacer una empresa
- Usar los benchmarks abiertos de IBM como referencia para evaluar agentes candidatos en los propios casos de uso, con pruebas de consistencia y coste, antes de cualquier despliegue en producción en los próximos seis meses.
Análisis generado por IA a partir de las noticias disponibles; actualizado 20 oct.
Relacionadas
LLM ×9agentes ×9Hugging Face ×5OpenAI ×2RAG ×2Anthropic ×1agentes de IA ×1IBM ×1ReAct ×1Artificial Analysis ×1
Historias
IBM lanza Granite Timeseries Ensemble para previsión de series temporales
IBM propone aprender reglas para mejorar agentes de atención al cliente
IBM Research presenta método para medir y mejorar consistencia de agentes IA
Calibración de memoria en agentes según capacidad del modelo
IBM Research optimiza memoria de agentes para reducir costes de inferencia
IBM Research: enrutamiento inteligente de modelos en agentes como problema de optimización sistémica
ScarfBench: evaluación de agentes de IA en modernización de aplicaciones Java
Brecha entre expectativas y realidad de los agentes de IA empresarial
Noticias
IBM Research publica Granite Timeseries Ensemble, un combinado de cuatro modelos abiertos para previsión de series temporales
IBM Research presentó en Hugging Face Granite Timeseries Ensemble, una receta que combina cuatro modelos preentrenados de series temporales y genera…
Por qué importaOfrece una opción por defecto para previsión de demanda o de series temporales sin tener que elegir arquitectura ni entrenar modelos propios. Los…
IBM Research logra un 67,5% en τ²-bench de atención al cliente con reglas aprendidas y GPT-4.1
IBM Research presenta ALTK-Evolve, un método que usa el propio modelo para extraer reglas de comportamiento de los intentos de entrenamiento y añadirlas al…
Por qué importaSugiere que parte de la mejora de los agentes de atención al cliente puede venir de la memoria y las instrucciones aprendidas, no solo de modelos más…
IBM Research presenta ALTK-Evolve para medir y mejorar la consistencia de agentes de IA
IBM Research publicó un método llamado 'consistency guidelines' dentro de su sistema ALTK-Evolve, que detecta pasos de decisión inestables en agentes LLM…
Por qué importaMuchos benchmarks reportan solo el promedio de éxito, ocultando que un agente puede fallar en tareas idénticas repetidas, lo que es crítico para…
IBM Research: agentes IA requieren dosis calibrada de memoria según su capacidad
IBM Research presenta ALTK-Evolve, un método que permite a agentes IA aprender de sus propias trayectorias previas sin actualizar pesos del modelo. La…
Por qué importaLa dosificación correcta de memoria en agentes IA es clave para optimizar rendimiento y eficiencia de costes en producción. Permite a empresas…

IBM Research optimiza memoria de agentes con ALTK-Evolve, reduciendo costes hasta el 85%
IBM Research presenta ALTK-Evolve, un sistema de memoria para agentes IA que aprende de trayectorias pasadas sin actualizar pesos ni requerir etiquetas…
Por qué importaLa eficiencia en costes de inferencia es crítica para viabilidad económica de agentes IA en producción. Un sistema que mantiene precisión mientras…
IBM Research: enrutar modelos en agentes de IA es un problema de optimización de sistemas
IBM Research publica en Hugging Face un análisis sobre el enrutamiento de modelos en sistemas de agentes. El equipo descubre que seleccionar entre modelos como…
Por qué importaPara equipos que construyen sistemas de agentes IA en producción, las decisiones sobre enrutamiento afectan directamente a costes reales, latencia y…
IBM Research lanza ScarfBench para evaluar agentes de IA en migraciones de frameworks Java
IBM Research ha presentado ScarfBench, un benchmark abierto para evaluar agentes de IA en tareas de migración de frameworks en aplicaciones empresariales Java…
Por qué importaLa modernización de aplicaciones empresariales es un desafío crítico para IT, y los agentes de IA se presentan como solución. Este benchmark expone…
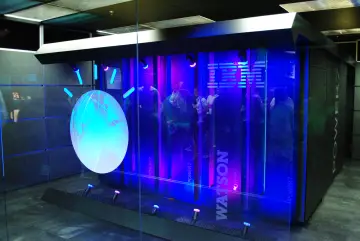
IBM demuestra agentes con lógica mejorada para adopción empresarial de IA
IBM Research ha publicado un análisis sobre cómo la lógica de agentes —software con grafos de conocimiento, análisis de programas y bibliotecas especializadas—…
Por qué importaDemuestra que la adopción de IA a escala en empresas requiere algo más que LLMs grandes: necesita "guía inteligente" (lógica de agentes) integrada en…
IBM y Artificial Analysis publican ITBench-AA: primer benchmark para agentes empresariales en IT
IBM Research y Artificial Analysis han publicado ITBench-AA, el primer benchmark diseñado específicamente para evaluar agentes de IA en tareas empresariales de…
Por qué importaEl benchmark evidencia que los modelos actuales aún no están listos para asumir de forma autónoma tareas IT complejas, lo cual es crítico para…
VAKRA: benchmark ejecutable para evaluar agentes IA en entornos empresariales
IBM Research ha presentado VAKRA, un benchmark ejecutable que evalúa cómo los agentes de IA razonan y actúan en entornos similares a los empresariales. El…
Por qué importaVAKRA representa un avance significativo en la evaluación de agentes IA porque mide capacidades compositivas reales en flujos de trabajo de múltiples…
IBM y UC Berkeley publican diagnóstico de fallos en agentes de IA empresariales con MAST
IBM Research y UC Berkeley presentaron MAST (Multi-Agent System Failure Taxonomy), una metodología para diagnosticar por qué fallan los agentes LLM en tareas…
Por qué importaLos benchmarks tradicionales reducen el rendimiento a un número único sin explicar las causas del fallo. MAST permite transformar el "por qué falló"…
IBM Research lanza AssetOpsBench para evaluar agentes IA en operaciones industriales reales
IBM Research ha presentado AssetOpsBench, un nuevo marco de evaluación diseñado específicamente para medir el desempeño de agentes IA en operaciones…
Por qué importaPara cualquier empresa que planee desplegar agentes IA en operaciones críticas o con riesgos industriales, este benchmark define por primera vez un…