Dharma-AI presenta un modelo de 2.000 millones de parámetros para extraer campos de documentos en JSON
Hecho Qué ha ocurrido
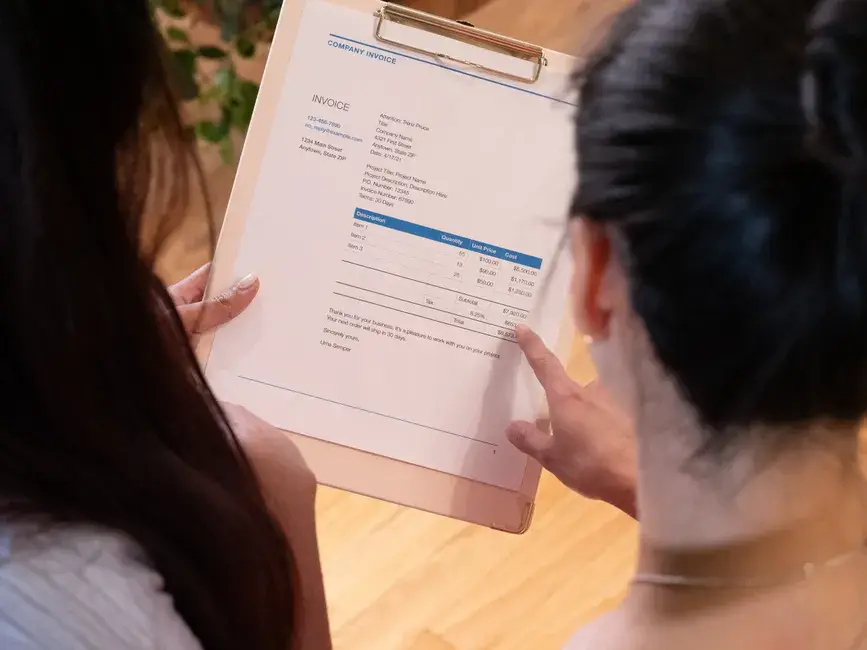
Dharma-AI presenta Field Extractor, un modelo de 2.000 millones de parámetros que, a partir de la imagen de un documento, devuelve campos estructurados en JSON según una petición abierta o un esquema. Según su propio benchmark de 546 documentos, obtiene una puntuación de 0,834 frente a 0,816 de Claude Opus 5 y 0,741 de GPT-5.6 Luna, con un coste de GPU en una L40S a 2,24 dólares por hora. La empresa indica que el coste por extracción es entre 6 y 147 veces menor que el de las APIs comparadas.
Resumen generado mediante IA a partir de Hugging Face (original en inglés). Naturaleza de la información: declaración de parte interesada.
Análisis Por qué importa
Para procesos de alto volumen como facturas, formularios o contratos, un modelo especializado y desplegable en infraestructura propia podría ser una alternativa a las APIs generalistas. Los resultados aún no están verificados por terceros.
- Quién se ve afectado
- Empresas con procesos documentales de alto volumen, como administración, finanzas, sanidad o cumplimiento normativo.
- Qué puede cambiar
- Si los resultados se confirman, podría reducirse el coste de automatizar la extracción de datos de documentos y disminuir la dependencia de APIs de modelos generalistas.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Evaluaciones independientes del benchmark, rendimiento sobre documentos reales fuera de los datos de la empresa y la adopción de este modelo frente a alternativas de código abierto y APIs comerciales.
Recomendación Qué debería hacer una empresa
Probar el modelo con una muestra de documentos propios durante 1-2 meses y comparar precisión y coste frente a la solución actual antes de tomar cualquier decisión.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: Hugging Face (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗OCRmodelos pequeños especializadosLoRAextracción de información Dharma-AIAnthropicOpenAI benchmark Dharma AI DharmaOCR-LITE extracción de datos Field Extractor
Relacionadas
Modelos especializados pequeños superan a los más grandes en OCR, con 52x menos coste
Dharma AI publicó un benchmark donde un modelo de 3 mil millones de parámetros especializado en OCR para portugués brasileño superó a todos los modelos…
Por qué importaLas empresas llevan años pagando por modelos frontera asumiendo que mayor tamaño garantiza mejor rendimiento. Este benchmark demuestra que la…
DharmaOCR demuestra ventaja de especialización en OCR frente a modelos multilingües
Dharma-AI publicó resultados comparativos de su modelo DharmaOCR, especializado en portugués brasileño, contra dos modelos multilingües recientes: Mistral OCR4…
Por qué importaEl análisis plantea una pregunta estratégica relevante para empresas con necesidades de OCR en idiomas específicos: si la especialización en dominio…
Anthropic publica FlashProve, código abierto para verificar criptográficamente que una API sirve el modelo pagado
Anthropic publicó FlashProve, un prototipo de código abierto bajo licencia Apache 2.0, que genera pruebas criptográficas basadas en zkSNARK para certificar que…
Por qué importaSi el estándar prospera, los clientes de API podrían comprobar qué modelo reciben realmente, algo que hoy no es verificable. Por ahora es una…
Anthropic desarrolla FlashProve, un sistema de código abierto para verificar qué modelo de IA generó una respuesta
Anthropic publicó en un blog un proyecto de código abierto llamado FlashProve, que busca ofrecer una prueba criptográfica de que una salida proviene de un…
Por qué importaSi funciona, permitiría comprobar que un proveedor no cambia en secreto a un modelo más barato o más caro, algo relevante para quien paga por el uso…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.