NVIDIA y Google optimizan Gemma 4 para IA agencial local en GPUs RTX
Hecho Qué ha ocurrido
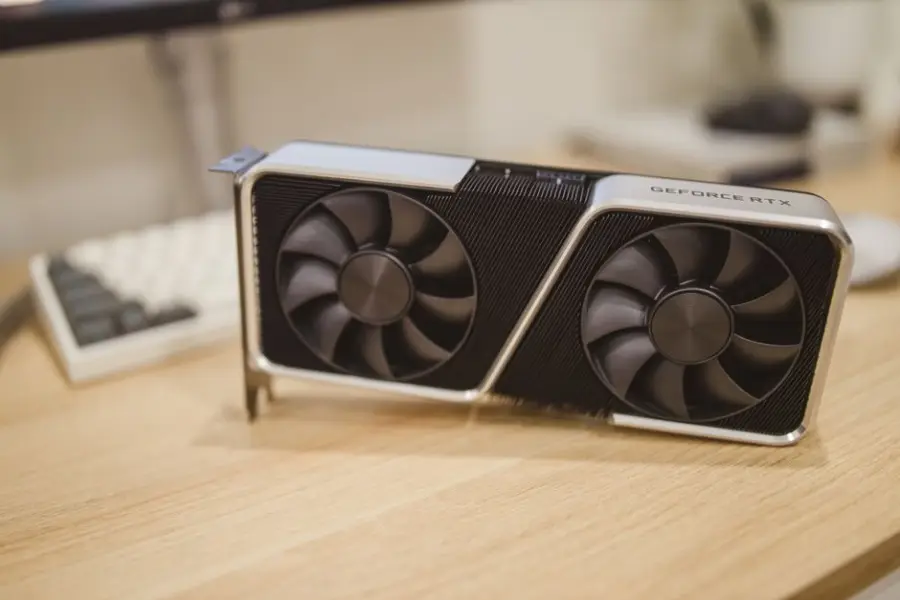
Google y NVIDIA han colaborado para optimizar la familia Gemma 4 de modelos de código abierto en GPUs de NVIDIA, con variantes de 2B, 4B, 26B y 31B parámetros. Los modelos están diseñados para ejecución eficiente en dispositivos locales, desde módulos Jetson Orin Nano hasta PCs con RTX, workstations y el DGX Spark. Gemma 4 incorpora capacidades multimodales (visión, vídeo, audio), soporte para 35+ idiomas, razonamiento, generación de código y herramientas nativas para agentes (function calling).
Resumen generado mediante IA a partir de NVIDIA Blog (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
Marca un hito en la carrera por la IA local y de bajo coste: modelos potentes ejecutándose sin dependencia de APIs en la nube, con latencia cercana a cero y privacidad garantizada. Para empresas es crítico porque reduce costes de inferencia, aumenta control sobre datos sensibles y permite desplegar asistentes inteligentes siempre disponibles sin conexión.
- Quién se ve afectado
- Desarrolladores, equipos de DevOps, empresas medianas y grandes con flujos de trabajo de IA local, proveedores de software de productividad, startups de agentes autónomos, y organizaciones con requisitos de privacidad o infraestructura edge.
- Qué puede cambiar
- La ecuación económica de los agentes IA: pasar de modelos en cloud (coste por token) a ejecución local en hardware propio reduce significativamente costes operacionales. También normaliza que aplicaciones de escritorio y dispositivos edge ejecuten razonamiento complejo sin conectividad continua.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Tasa de adopción en dev tools y aplicaciones de escritorio (OpenClaw, Ollama); desempeño en benchmarks de agentes abiertos; velocidad de optimizaciones por parte de NVIDIA en nuevas generaciones de RTX; competencia de AMD, Intel y proveedores de chips alternativos en este espacio; impacto en precios de GPUs consumer.
Recomendación Qué debería hacer una empresa
Evaluar en los próximos 3-6 meses si Gemma 4 puede reemplazar APIs pagadas en workflows de desarrollo y agentes internos. Crear pilots con modelos E4B y 26B en entornos RTX locales para validar latencia, coste y precisión antes de migrar aplicaciones en producción.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: NVIDIA Blog (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗LLMagentesmultimodaledge AIquantization GoogleNVIDIA agentes Gemma 4 IA local modelos abiertos RTX
Relacionadas
Gemma 4 VLA se ejecuta en Jetson Orin Nano Super con visión multimodal
NVIDIA ha publicado un tutorial demostrando cómo ejecutar Gemma 4, un modelo de agente visual de lenguaje (VLA), en hardware de bajo consumo Jetson Orin Nano…
Por qué importaDemuestra que los agentes multimodales sofisticados pueden ejecutarse de forma eficiente en dispositivos edge con restricciones severas de memoria y…
Google DeepMind lanza Gemma 4: modelos abiertos de máxima capacidad por parámetro
Google DeepMind ha presentado Gemma 4, una familia de modelos de código abierto bajo licencia Apache 2.0 en cuatro tamaños: 2B, 4B, 26B (Mixture of Experts) e…
Por qué importaGemma 4 elimina la necesidad de hardware costoso para acceder a capacidades de razonamiento avanzado y flujos de trabajo agénticos, permitiendo que…
Google DeepMind presenta Gemma 4 12B: modelo multimodal sin codificadores para portátiles
Google DeepMind ha lanzado Gemma 4 12B, un modelo multimodal diseñado para ejecutarse localmente en portátiles con 16GB de RAM. El modelo adopta una…
Por qué importaDemocratiza la IA multimodal avanzada llevándola a dispositivos de consumo sin dependencia de servidores en la nube, reduciendo latencia y costes…
Google DeepMind lanza Gemma 4 en Amazon Bedrock con variantes eficientes
AWS anuncia la disponibilidad de Gemma 4, familia de modelos de código abierto creados por Google DeepMind bajo licencia Apache 2.0, en su servicio Amazon…
Por qué importaLos modelos abiertos de alto rendimiento en una plataforma completamente gestionada permiten a las empresas adoptar IA con control total de datos…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.