AWS y Anthropic optimizan extracción de documentos con pipeline de dos modelos
Hecho Qué ha ocurrido
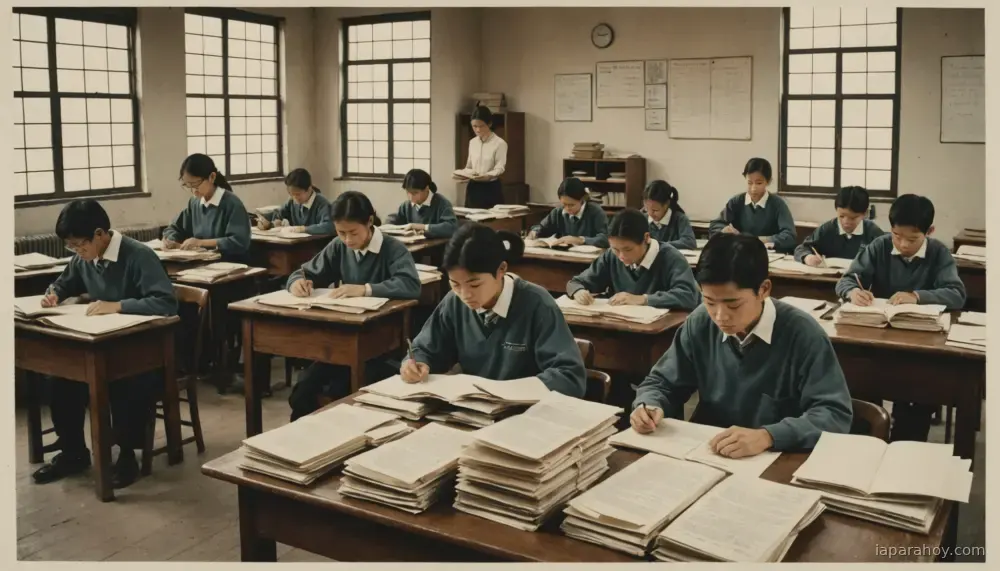
AWS publicó un caso de uso en el que combina Amazon Nova 2 Lite con Claude Sonnet 4.6 en Amazon Bedrock para digitalizar documentos escaneados a escala. El pipeline procesa páginas de anuarios escolares detectando fotos y nombres, y asociando ambos mediante razonamiento espacial, logrando 93% de confianza en 3.122 asociaciones nombre-cara en 336 páginas. La solución cuesta aproximadamente dos tercios menos por página que usar un único modelo de visión para la tarea completa.
Resumen generado mediante IA a partir de AWS Machine Learning Blog (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
Demuestra una estrategia práctica y económica de composición de modelos: delegar tareas específicas al modelo más eficiente según su coste y capacidad reduce gastos operacionales en volumen sin sacrificar precisión. Relevante para cualquier empresa procesando miles de documentos visuales con IA.
- Quién se ve afectado
- Empresas de servicios documentales, archivos digitales, fintech con validación de documentos y cualquier sector que procese documentación masiva escaneada.
- Qué puede cambiar
- Hace viables proyectos de digitalización masiva de archivos históricos o administrativos que antes eran prohibitivos en coste. La fijación de precios de imagen en Nova 2 Lite elimina incertidumbre en proyecciones de costes por resolución.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Adopción de este patrón de pipelines multi-modelo en clientes de AWS; evolución de precios de modelos menores tipo Nova frente a modelos de razonamiento grandes; disponibilidad de Nova 2 Lite y Claude en nuevas regiones de Bedrock.
Recomendación Qué debería hacer una empresa
Evaluar este patrón en los próximos 3-6 meses si tu empresa procesa >10.000 documentos visuales anuales: prototipar con datos representativos en Bedrock y comparar coste real contra soluciones monolíticas.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: AWS Machine Learning Blog (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗LLMvisión multimodalrazonamiento espacialAmazon BedrockNova 2 Lite Amazon Web ServicesAnthropic AWS Bedrock Claude extracción documental Nova optimización de costes
Relacionadas
AWS presenta pipeline de redacción automática de datos personales en imágenes con Nova
AWS publicó una solución basada en Amazon Nova 2 Lite que coordina un pipeline multi-paso para detectar y redactar información personal (PII) en imágenes. La…
Por qué importaLas organizaciones que manejan grandes volúmenes de imágenes enfrentan riesgos regulatorios significativos bajo GDPR, HIPAA y PCI DSS si no redactan…
Anthropic y AWS lanzan Claude Sonnet 5.5 en Amazon Bedrock para tareas de codificación
AWS anunció la disponibilidad de Claude Sonnet 5.5 en Amazon Bedrock y Claude Platform on AWS. El modelo ofrece menor coste por tarea y mayor velocidad que…
Por qué importaReduce costes operativos para empresas que ya usan Bedrock en tareas de codificación y análisis a gran escala, manteniendo residencia de datos y…
AWS publica arquitectura serverless para búsqueda inteligente de fotos con Rekognition, Neptune y Bedrock
AWS publicó un tutorial detallado en su blog de Machine Learning mostrando cómo construir un sistema de búsqueda de fotos inteligente usando AWS CDK, que…
Por qué importaIlustra cómo combinar múltiples servicios de AWS (visión por computadora, bases de datos de grafos y modelos de lenguaje) para resolver problemas…
AWS Bedrock presenta pipelines flexibles para extracción de datos de documentos
AWS publicó en su blog de Machine Learning un tutorial técnico sobre un sistema de procesamiento de documentos con dos opciones de inferencia en Amazon…
Por qué importaLas empresas con grandes backlogs de documentos no estructurados pueden automatizar la extracción de datos con flexibilidad económica: usar…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.