DeepMind logra rendimiento a nivel humano en agentes cooperativos multiagente con Quake III
Hecho Qué ha ocurrido
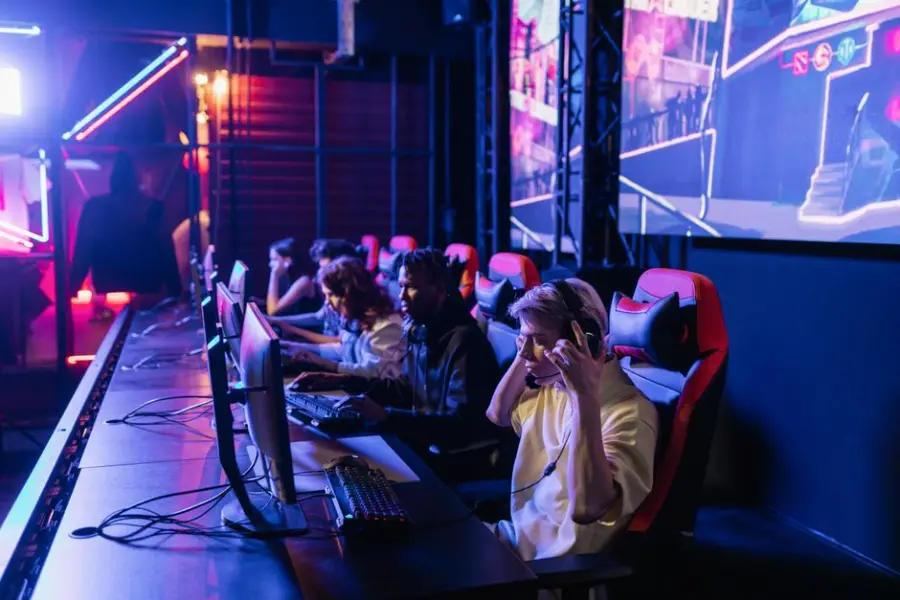
Google DeepMind publica en Science un estudio sobre agentes de aprendizaje por refuerzo que alcanzan rendimiento a nivel humano en Capture the Flag de Quake III Arena, un juego multijugador 3D. Los agentes, llamados FTW (For The Win), aprenden directamente de píxeles, cooperan con compañeros artificiales y humanos, y superan a jugadores humanos incluso cuando se entrenan con tiempos de reacción similares a los humanos (267 ms). El método ha escalado desde el escenario de investigación a todo el juego de Quake III Arena.
Resumen generado mediante IA a partir de Google DeepMind (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
Este avance demuestra que los sistemas de IA pueden resolver problemas complejos de aprendizaje multiagente con cooperación y competencia simultáneas, una capacidad fundamental para sistemas autónomos en entornos del mundo real. Las técnicas desarrolladas tienen aplicaciones potenciales en robótica, sistemas colaborativos y simulación táctica.
- Quién se ve afectado
- Investigadores de IA, empresas de roboticidad y automatización, y desarrolladores de sistemas multiagente cooperativos; también de interés para estudios de comportamiento emergente y diseño de agentes autónomos.
- Qué puede cambiar
- Valida métodos de entrenamiento por refuerzo para entornos complejos y dinámicos con múltiples objetivos conflictivos. Abre camino a entrenar sistemas que aprenden tanto cooperación efectiva como competencia, sin instrucciones explícitas sobre reglas o tácticas.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Adopción de estas técnicas en simuladores industriales y robóticos; evolución hacia entornos más complejos del mundo real; publicación de herramientas y benchmarks derivados; y cómo industrias como defensa, logística y manufactura colaborativa evalúan estas capacidades.
Recomendación Qué debería hacer una empresa
Laboratorios de IA y equipos de roboticidad deberían revisar los métodos de aprendizaje multiagente publicados en el paper en los próximos 6-12 meses para evaluar aplicabilidad en sus entornos operacionales específicos.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: Google DeepMind (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗aprendizaje por refuerzoagentes multiagentevisión por computadoraredes neuronales agentes multiagente aprendizaje por refuerzo cooperación Google DeepMind Quake III
Relacionadas
DeepMind logra que agentes de IA aprendan comportamientos complejos observando demostraciones
Google DeepMind ha desarrollado agentes de inteligencia artificial capaces de transferencia cultural en tiempo real mediante aprendizaje por refuerzo profundo…
Por qué importaEste avance abre la posibilidad de que sistemas de IA aprendan de manera flexible y rápida a partir de observaciones, sin requerir grandes conjuntos…
Agent57: primer agente de refuerzo profundo que supera nivel humano en todos los juegos Atari
DeepMind ha desarrollado Agent57, el primer agente de aprendizaje por refuerzo profundo que obtiene puntuaciones superiores al nivel humano en los 57 juegos de…
Por qué importaRepresenta un hito significativo en la generalización de agentes de RL: demuestra que es posible entrenar un único sistema capaz de adaptarse a…
DeepMind logra agentes generales capaces de aprender múltiples juegos sin reentrenamiento
DeepMind publica un preprint sobre agentes entrenados con aprendizaje por refuerzo en abierto (open-ended learning) capaces de jugar múltiples juegos sin…
Por qué importaEste avance aborda una limitación fundamental del aprendizaje por refuerzo: la incapacidad de generalizar entre tareas diferentes sin…
DeepMind presenta UNREAL, algoritmo de aprendizaje por refuerzo 10x más rápido
Google DeepMind ha publicado un paper sobre UNREAL (UNsupervised REinforcement and Auxiliary Learning), un método que mejora significativamente la velocidad y…
Por qué importaAcelerar el aprendizaje en sistemas de refuerzo es crítico para hacer que la IA sea aplicable a problemas complejos del mundo real sin requerir datos…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.