Ingenieros logran que modelos de lenguaje como GPT-6 conduzcan un coche real sin entrenamiento específico
Hecho Qué ha ocurrido
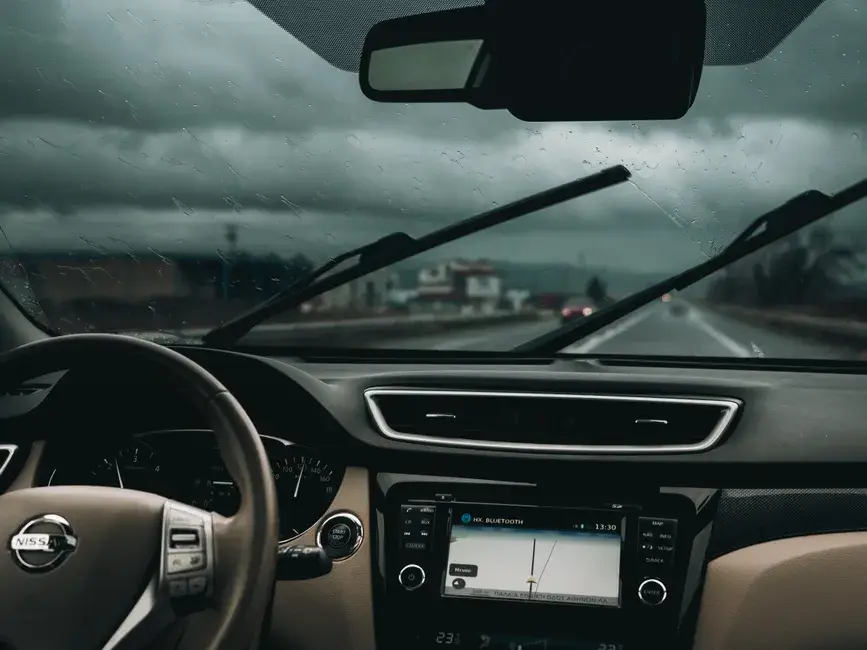
Tres ingenieros de la startup Axiom conectaron modelos de OpenAI (GPT-6 Astra), Anthropic (Claude Fable 5.1) y xAI (Grok) a las cámaras y la dirección asistida de un Toyota Corolla para que condujeran hasta una ventanilla de In-N-Out. Solo Astra completó el trayecto con éxito, aunque muy lentamente; en su propio benchmark DrivingBench, Claude completó el 45% de un circuito y Grok el 11%. Los modelos no fueron entrenados específicamente para conducir; su capacidad parece emerger del entrenamiento multimodal en razonamiento 3D.
Resumen generado mediante IA a partir de Wired AI (original en inglés). Naturaleza de la información: declaración de parte interesada.
Análisis Por qué importa
Sugiere que los modelos de propósito general empiezan a desarrollar comprensión física incipiente más allá del texto, lo que podría abrir aplicaciones en robótica y sistemas que operan en el mundo real sin entrenamiento específico para cada tarea.
- Quién se ve afectado
- Empresas de robótica, automoción autónoma, startups de IA física y laboratorios que desarrollan modelos multimodales.
- Qué puede cambiar
- Si se confirma esta tendencia, los modelos generalistas podrían servir como base para tareas físicas antes reservadas a sistemas especializados, reduciendo la necesidad de entrenamiento dedicado.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Vigilar la evolución de benchmarks como DrivingBench o Humanity's Sixth Sense, y si los grandes laboratorios de IA empiezan a optimizar explícitamente el razonamiento físico y espacial en próximos modelos.
Enviar esta noticia por correo
Fuente original: Wired AI. La referencia es siempre el artículo original.
Ver fuente original ↗multimodalrazonamiento espacialrobóticaLLM OpenAIAnthropicxAIAxiomElorian AI benchmarksconducción autónomaGPT-6razonamiento físico
Tu opinión
0 comentarios
Relacionadas
NVIDIA logra nivel oro en las olimpiadas IMO e IOI 2026 con modelos Nemotron especializados
NVIDIA afinó su familia de modelos Nemotron 3 mediante SFT, aprendizaje por refuerzo e inferencia con feedback para competir en matemáticas (IMO 2026) y…
Por qué importaDemuestra que modelos de propósito general pueden especializarse en dominios de razonamiento extremo mediante recetas reproducibles de fine-tuning y…
OpenAI publica 372 resultados matemáticos generados por IA y provoca advertencia de 25 medallistas Fields
OpenAI publicó en GitHub 372 resultados matemáticos generados por un modelo interno de frontera, con formalizaciones en Lean para verificación automática. Cada…
Por qué importaMarca un intento de desplazar la validación científica desde las revistas peer-reviewed hacia repositorios de código verificados formalmente…
OpenAI publica 377 nuevos resultados matemáticos tras críticas por falta de transparencia
OpenAI ha publicado 377 nuevos resultados matemáticos generados por un modelo interno, supervisados por un Grupo Asesor sobre Matemáticas e IA. Los resultados…
Por qué importaMuestra cómo OpenAI intenta recuperar credibilidad científica tras un episodio de sobreventa de resultados, algo relevante para quienes evalúan la…
OpenAI publica cientos de resultados matemáticos obtenidos con un modelo interno aún no lanzado
OpenAI publicó 722 manuscritos agrupados en 372 familias de resultados matemáticos, generados por un modelo interno todavía no lanzado tras someterlo a unos…
Por qué importaMuestra el avance de modelos de IA aún no comerciales en razonamiento matemático avanzado, lo que podría anticipar capacidades futuras de productos…