Tecnología
difusión
La difusión es una familia de modelos generativos que crean imágenes, vídeo, audio e incluso texto a partir de ruido iterativamente refinado. Es la base técnica detrás de herramientas como Stable Diffusion, FLUX o Veo, y se extiende cada vez más a dominios como robótica y biología molecular.
Sobre esta tecnología, IA para hoy ha analizado 16 noticias, procedentes de 9 medios distintos. En los últimos siete días han sido 1, frente a las 0 de la semana anterior. La fiabilidad media de esa cobertura es de 3,9 sobre 5, medida con las reglas de nuestro método. Las áreas de impacto que más se repiten son Desarrollo, Operaciones, Productividad. Aparece en 8 historias en seguimiento.
Evolución en 16 semanas
El momentum semanal se estima con la misma fórmula que el momentum actual: volumen, aceleración respecto a la semana anterior, diversidad de fuentes e impacto.
Análisis Qué significa para una empresa
- Oportunidades
- Permite generar contenido visual y audiovisual de marca a gran escala y bajo coste (publicidad, marketing, prototipado), entrenar sistemas de visión con datos sintéticos cuando los reales son escasos o peligrosos, y acelerar la investigación científica e industrial (biología, robótica). La disponibilidad de modelos abiertos y optimizados para hardware local reduce la dependencia de la nube.
- Riesgos
- Existe dependencia de proveedores de modelos y GPU especializada, además de incertidumbre regulatoria sobre contenido sintético (deepfakes, derechos de autor). La calidad y fiabilidad varían según el dominio, y la integración en productos de uso diseñado para humanos requiere control de calidad y etiquetado de contenido generado.
- Qué debería hacer una empresa
- Las empresas con necesidades de producción visual o de datos sintéticos deberían evaluar pilotos con modelos de difusión abiertos en los próximos 6 meses, priorizando casos de uso con retorno medible como marketing o aumento de datos de entrenamiento.
Análisis generado por IA a partir de las noticias disponibles; actualizado 19 oct.
Relacionadas
Hugging Face ×4Google DeepMind ×4LLM ×3Nvidia ×3AWS ×3robótica ×3multimodal ×2visión por computadora ×2Anthropic ×1Google ×1
Historias
Hugging Face integra Trainium con TorchNeuron
Google Research presenta framework Diffusion Controller para generación de imágenes
AWS presenta pipeline de datos sintéticos para IA de seguridad industrial
Gen-COMPAS: IA generativa para simular transiciones moleculares raras
Integración de cuantización Nunchaku en Diffusers
Grabette: sistema abierto de captura de datos para robótica
Lanzamiento de DiffusionGemma: modelo de generación de texto paralela de Google
Bark.com reduce producción de vídeo de semanas a horas con AWS
Noticias
Hugging Face recomienda usar Transformers y TRL directamente en Trainium con TorchNeuron
Hugging Face anuncia que TorchNeuron, un plugin de PyTorch con un nuevo backend para los chips Trainium de AWS, llegará en beta pública el 20 de octubre de…
Por qué importaReduce la necesidad de forks específicos del modelo y de código propio de Neuron, lo que simplifica el mantenimiento de pipelines de entrenamiento y…
Google Research presenta Diffusion Controller, framework para dirigir generación de imágenes en modelos cerrados
Investigadores de Google Research presentan Diffusion Controller, una red ligera tipo 'amortiguador de dirección' que se acopla a modelos de difusión de texto…
Por qué importaOfrece una forma unificada y más controlable de ajustar modelos de imagen sin necesidad de acceso a sus pesos internos, lo que podría facilitar la…
AWS usa datos sintéticos con SageMaker y Rekognition para mejorar la detección de personas en entornos industriales peligrosos
AWS describe un pipeline que usa el modelo de difusión Qwen-Image-Edit-2509 en SageMaker AI para insertar personas sintéticas en imágenes reales de maquinaria…
Por qué importaOfrece una vía práctica para entrenar modelos de seguridad industrial en escenarios raros y peligrosos que son costosos y arriesgados de recopilar en…
Investigadores usan difusión generativa para simular transiciones moleculares raras
Un equipo publicó en Nature Gen-COMPAS, un marco de muestreo de trayectorias guiado por 'committor' que combina un modelo de difusión probabilística generativo…
Por qué importaReduce órdenes de magnitud el coste de simular eventos moleculares raros clave en plegamiento de proteínas, alosteria y transporte de membrana, lo…
Hugging Face integra cuantización Nunchaku 4-bit en Diffusers para inferencia de imagen más rápida
Hugging Face ha integrado la técnica de cuantización SVDQuant de Nunchaku directamente en su librería Diffusers, permitiendo cargar modelos de difusión con…
Por qué importaEsta integración democratiza la optimización de inferencia de modelos de difusión, reduciendo barreras técnicas y permitiendo a más empresas…
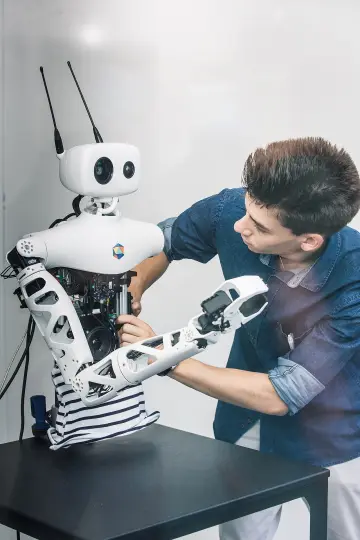
Hugging Face lanza Grabette, sistema abierto para capturar datos de manipulación robótica
Hugging Face ha publicado Grabette, un sistema de bajo coste y código abierto para grabar datos de manipulación robótica mediante una mano humana equipada con…
Por qué importaAborda un cuello de botella crítico en el aprendizaje robótico: la escasez de datos de manipulación en el mundo real, diversos y a escala. Al…
Google presenta DiffusionGemma, modelo de IA que genera texto 10 veces más rápido
Google ha lanzado DiffusionGemma, un modelo experimental que genera texto en bloques de 256 tokens simultáneamente en lugar de token a token como los modelos…
Por qué importaEsta arquitectura alterna (difusión frente a autorregresiva) abre posibilidades para ejecución local en hardware de consumo y habilita tareas de…
Bark.com reduce producción de vídeo de semanas a horas con AWS y IA generativa
Bark.com colaboró con el AWS Generative AI Innovation Center para desarrollar una solución de generación de contenido de vídeo que reduce el tiempo de…
Por qué importaPara empresas de marketing y generación de contenido, demuestra un patrón arquitectónico escalable que reduce drásticamente el tiempo de ciclo de…
Photoroom entrena modelo de difusión de texto a imagen en 24 horas
Photoroom ha completado una demostración práctica (speedrun) de entrenamiento de un modelo de difusión texto-a-imagen en 24 horas, combinando múltiples…
Por qué importaDemuestra que la brecha de costes en entrenamiento de modelos generativos se ha cerrado significativamente gracias a optimizaciones de ingeniería…
AlphaFold revoluciona la predicción de estructuras proteicas: de experimentos a simulaciones
El artículo analiza el impacto de AlphaFold, desarrollado por Google DeepMind, que predice estructuras 3D de proteínas a partir de su secuencia sin…
Por qué importaPara directivos en farmacéutica, biotecnología y química, AlphaFold acelera descubrimiento de fármacos al eliminar ciclos costosos de prueba y error…
NVIDIA presenta Cosmos Policy para control avanzado de robots con modelos de fundación de video
NVIDIA ha lanzado Cosmos Policy, una nueva política de control de robots basada en post-entrenar el modelo de fundación de video Cosmos Predict-2 para tareas…
Por qué importaRepresenta un avance significativo en control robótico mediante la reutilización de modelos de fundación de video preentrenados, reduciendo datos…
NVIDIA potencia la generación de imagen y vídeo con IA en PCs locales con RTX
NVIDIA impulsa un modelo de creación generativa de contenido visual ejecutado en local mediante GPUs RTX, frente al predominio de herramientas basadas en nube…
Por qué importaPara empresas creativas y profesionales, esto representa un cambio en el modelo de operación: reducir dependencia de servicios en nube, mejorar…
Black Forest Labs lanza FLUX.2-klein-4B y Salvatore Sanfilippo la implementa en C puro
El 15 de enero, Black Forest Labs (creadores de Stable Diffusion) lanzó FLUX.2-klein-4B, un modelo de difusión de texto a imagen con 4.000 millones de…
Por qué importaLa portabilidad y eficiencia de una implementación de modelo difusivo en C puro reduce barreras técnicas para ejecutar generación de imágenes en…
Google integra modelos Veo e Imagen 3 en YouTube Shorts para creadores de video
Google DeepMind lanzará en los próximos meses sus modelos de generación de video Veo e Imagen 3 integrados en Dream Screen, la herramienta de YouTube Shorts…
Por qué importaMillones de creadores de contenido tendrán acceso a herramientas de generación de video profesional integradas en la plataforma que ya usan…
Google DeepMind presenta ALOHA Unleashed y DemoStart para robótica de destreza
Google DeepMind ha publicado dos nuevos sistemas de IA para robótica: ALOHA Unleashed, que permite a robots bimanual realizar tareas complejas como atar…
Por qué importaEstos avances representan un paso crítico hacia robots útiles en entornos reales de trabajo y hogar, reduciendo drásticamente el tiempo y coste de…
Google DeepMind presenta V2A: generación de audio sincronizado a partir de vídeo
Google DeepMind ha publicado su investigación sobre tecnología video-to-audio (V2A), que genera bandas sonoras sincronizadas a partir de píxeles de vídeo y…
Por qué importaCompleta el ciclo de generación de contenido audiovisual completo, permitiendo producir vídeos con sonido sincronizado sin intervención manual. Para…