Tecnología
inferencia
La inferencia es el proceso de ejecutar un modelo de IA ya entrenado para producir resultados reales (texto, imágenes, decisiones) en producción, a diferencia del entrenamiento, que crea el modelo. Es el coste operativo recurrente de usar IA y, por eso, el principal foco actual de inversión en chips, infraestructura y servicios especializados.
Sobre esta tecnología, IA para hoy ha analizado 104 noticias, procedentes de 18 medios distintos. En los últimos siete días han sido 13, frente a las 8 de la semana anterior. La fiabilidad media de esa cobertura es de 2,9 sobre 5, medida con las reglas de nuestro método. Las áreas de impacto que más se repiten son IT, Operaciones, Desarrollo. Aparece en 8 historias en seguimiento.
Evolución en 16 semanas
El momentum semanal se estima con la misma fórmula que el momentum actual: volumen, aceleración respecto a la semana anterior, diversidad de fuentes e impacto.
Análisis Qué significa para una empresa
- Oportunidades
- Permite reducir costes y latencia al desplegar IA en producción, y abre un mercado de proveedores especializados (chips propios, nubes de inferencia, redes distribuidas) que puede abaratar el acceso frente a depender solo de GPU de Nvidia. También facilita nuevos modelos de negocio basados en vender capacidad de cómputo ociosa o servicios de optimización automática.
- Riesgos
- Alta dependencia de proveedores de infraestructura (hiperescalares, fabricantes de chips) y de promesas de rendimiento aún no validadas de forma independiente. La fragmentación de opciones (chips propios, redes de PCs domésticos, nubes especializadas) exige evaluación cuidadosa de fiabilidad, seguridad y coste real antes de comprometerse.
- Qué debería hacer una empresa
- Las empresas que ya usan IA en producción deberían revisar en los próximos 6 meses sus costes de inferencia y evaluar alternativas (optimización de despliegue, proveedores especializados) para evitar sobrecostes a medida que escala el uso.
Análisis generado por IA a partir de las noticias disponibles; actualizado 18 oct.
Relacionadas
LLM ×53Nvidia ×45chips ×32OpenAI ×23AWS ×18Anthropic ×17agentes ×15Microsoft ×15Amazon ×13Amazon Web Services ×13
Historias
AWS publica guías para TTS en SageMaker: autoescalado y streaming de voz
Coste del almacenamiento de datos generados por la inferencia de IA
Equinix lanza red EPIC de centros de prueba para IA con refrigeración líquida
Guía de perfilado de inferencia en Trainium con TorchNeuron
DeepSeek publica en GitHub su framework de inferencia DeepInfer
NVIDIA y socios cloud amplían infraestructura de IA en Europa
Alibaba impulsa RISC-V con su CPU XuanTie C950 y 6.000 millones de unidades
Deepseek publica el motor de inferencia DeepInfer
Noticias
AWS explica cómo calibrar el autoescalado de un endpoint TTS con Kokoro-82M en SageMaker AI
AWS Machine Learning Blog publica una guía para desplegar el modelo de síntesis de voz Kokoro-82M como contenedor personalizado en un endpoint de Amazon…
Por qué importaPara equipos que operan síntesis de voz propia, un umbral mal estimado puede tanto desperdiciar GPU como incumplir la latencia comprometida sin que…
WD advierte de que el almacenamiento de datos generados por la inferencia de IA es un coste poco previsto
Un artículo patrocinado por WD, publicado en MIT Technology Review, sostiene que la inferencia de IA genera grandes volúmenes de datos de respaldo que hay que…
Por qué importaEl presupuesto de IA suele centrarse en cómputo y el almacenamiento puede crecer sin control detrás de los costes de GPU. Conviene incluir la…
Equinix abre EPIC, una red de centros con refrigeración líquida para probar infraestructura de IA antes de desplegarla
Equinix anuncia EPIC (Enhanced Performance Innovation Centers), una red internacional de espacios con refrigeración líquida preparados para entornos de…
Por qué importaPara empresas que planeen desplegar IA de alta densidad, la refrigeración afecta al rendimiento, la velocidad y el coste, por lo que probar la…
Amazon explica cómo perfilar modelos PyTorch en sus chips Trainium con TorchNeuron
Amazon publica en Hugging Face la primera parte de una guía sobre perfilado de rendimiento de inferencia en AWS Trainium con TorchNeuron, su backend nativo de…
Por qué importaPara equipos que ejecutan modelos en hardware de Amazon, identificar dónde se consume el tiempo de inferencia permite reducir costes sin cambiar el…
DeepSeek libera en GitHub DeepInfer, el motor de inferencia que usa en producción para sus modelos
DeepSeek publicó en GitHub, desde el 16 de octubre, DeepInfer, el framework de inferencia que usa en producción, con licencia Apache 2.0. La primera versión…
Por qué importaDa a las empresas una ruta oficial para servir modelos de DeepSeek en su propia infraestructura, sin enviar datos a terceros. También sube el listón…
Socios cloud de NVIDIA amplían capacidad de IA en Europa, África y Asia Central con modelos abiertos y control de agentes
NVIDIA informa de que sus socios cloud en Europa, los países nórdicos, África y Asia Central están ampliando capacidad de cómputo regional para entrenamiento e…
Por qué importaPara empresas europeas abre opciones de nube regional con control sobre dónde residen los datos y cargas, y muestra que modelos abiertos ajustados a…
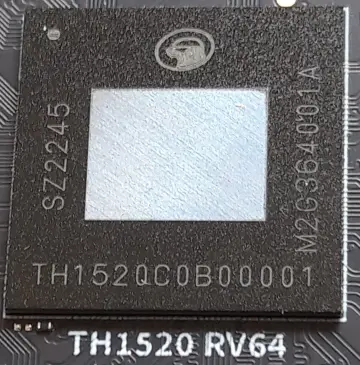
Alibaba supera los 6.000 millones de procesadores RISC-V enviados con su línea XuanTie
La Academia DAMO de Alibaba ha anunciado que los procesadores basados en su arquitectura XuanTie han superado los 6.000 millones de unidades enviadas. T-Head…
Por qué importaMuestra que una arquitectura abierta como RISC-V se consolida como base de cómputo para IA fuera del ecosistema de Nvidia y Arm, lo que afecta a la…
Deepseek publica en código abierto DeepInfer, el motor de inferencia de su modelo más rápido y barato
Deepseek ha publicado con licencia Apache 2.0 DeepInfer, su framework interno de inferencia que sirve su modelo V4.1-Flash. Está basado en vLLM e incorpora…
Por qué importaReducir el coste de servir modelos abiertos facilita a las empresas desplegarlos por su cuenta a menor precio. La publicación añade presión sobre los…
Amazon lanza TorchNeuron para llevar apps de PyTorch a sus chips Trainium con un cambio de configuración
AWS ha publicado TorchNeuron, una herramienta que permite trasladar aplicaciones de IA escritas en PyTorch al chip Trainium de Amazon. Según Amazon, basta con…
Por qué importaReduce una de las barreras que mantenían a los desarrolladores atados a las GPU de Nvidia, y da una alternativa de hardware y nube a quien construye…
Deepgram reporta entre 11 y 70 % más audio procesado por dólar al portar Nova-3 a AWS Trainium2
Deepgram, con el equipo de ingeniería de AWS, adaptó su modelo de voz a texto Nova-3 a AWS Trainium2 para transcripción por lotes. Según la propia empresa y…
Por qué importaPara proveedores de voz con gran volumen de transcripción, el coste por hora de audio depende del hardware y del software de inferencia tanto como…
AWS describe transferencia KV bidireccional en vLLM que reduce el TTFT en cargas agénticas multiturno
AWS Machine Learning Blog explica una técnica de transferencia bidireccional de caché KV en vLLM para cargas agénticas multiturno, en la que el nodo de…
Por qué importaLas aplicaciones de agentes que reenvían historiales largos en cada turno pueden acumular latencia y coste de cómputo; reutilizar contexto ya…
Substrate AI prevé superar los 100 millones de euros de facturación en 2030 con tecnología propia
Substrate AI, empresa cotizada en BME Growth, presentó en Madrid, durante el AI SUMMIT, un plan estratégico aprobado por unanimidad por su consejo de…
Por qué importaMuestra a un proveedor español de IA que intenta integrarse verticalmente, de la infraestructura al modelo y al servicio, algo que puede afectar a…
Microsoft detalla Azure Maia 300, la próxima generación de su acelerador de IA, con despliegue en producción previsto para 2027
Microsoft presenta Azure Maia 300, sucesor del Azure Maia 200, un acelerador para IA diseñado para despliegues de varios gigavatios. La compañía afirma que…
Por qué importaMuestra que los grandes proveedores de nube buscan reducir su dependencia de las GPU de terceros para ejecutar inferencia, lo que podría influir a…
Substrate AI se marca el objetivo de superar los 100 millones de euros de facturación en 2030
La compañía española de IA Substrate AI ha fijado como objetivo superar los 100 millones de euros de facturación en 2030. Su hoja de ruta se apoya en tres…
Por qué importaMuestra un proveedor español que pasa de intermediar capacidad de computación a vender modelos y plataformas propias, con ingresos recurrentes como…
Blackfuel despliega una plataforma de inferencia de IA en el centro de datos BCN1 de Digital Realty en Barcelona
Blackfuel, especializada en inferencia de IA, ha elegido el centro de datos BCN1 de Digital Realty en Barcelona para desplegar y escalar su plataforma. La…
Por qué importaAcerca la inferencia de IA a los lugares donde ya están los datos y las aplicaciones de las empresas, lo que puede simplificar el uso de IA sin mover…
Microsoft presenta Maia 300, su chip de inferencia para centros de datos con despliegue previsto en 2027
Microsoft ha presentado Maia 300, la segunda generación de su chip propio para inferencia de IA en centros de datos. Según la compañía, procesa un 40% más de…
Por qué importaSi se confirma, reduciría la dependencia de Microsoft de las GPU de Nvidia para inferencia y podría cambiar su posición negociadora en precios de…
Microsoft presenta Maia 300, su chip de IA de tercera generación para 2027
Microsoft ha presentado Maia 300, su chip de IA de tercera generación, que llegará en 2027 y está diseñado para la inferencia. Según la compañía, ofrecerá un…
Por qué importaSi se confirma, Microsoft reduciría su dependencia de Nvidia y AMD en inferencia, lo que puede influir en la oferta y los costes de cómputo de sus…
Microsoft presenta Maia 300, su nuevo chip de IA que llegará en 2027
Microsoft ha presentado Maia 300, su chip de inteligencia artificial de tercera generación, que llegará en 2027. Está diseñado para optimizar la inferencia y…
Por qué importaUn chip propio optimizado para inferencia puede reducir la dependencia de proveedores externos de hardware y cambiar los costes de servir modelos en…
Microsoft presenta Maia 300, la tercera generación de sus chips de IA, con despliegue previsto en 2027
Microsoft ha presentado Maia 300, la tercera generación de sus aceleradores de IA, y ha fijado para 2027 el inicio de su despliegue en producción. La compañía…
Por qué importaLa decisión muestra que los grandes proveedores de nube buscan reducir su dependencia de NVIDIA y controlar el coste de la inferencia. Para las…
Microsoft prevé usar sus chips Maia a escala de gigavatios desde 2027 como sistema principal de inferencia
Microsoft anuncia que desplegará sus chips de IA Azure Maia a escala de varios gigavatios a partir de 2027, como sistema principal de inferencia en sus…
Por qué importaSi se cumple, Microsoft reduciría su dependencia de las GPU de terceros en la inferencia, lo que puede influir en costes y disponibilidad de los…
Microsoft presenta Maia 300, su tercer chip de IA propio, para reducir su dependencia de Nvidia
Microsoft anuncia su tercera generación de chip de IA propio, Maia 300, diseñado como sistema principal de inferencia para sus productos y servicios. Según…
Por qué importaSi el chip cumple lo prometido, Microsoft podría reducir el coste de ejecutar IA en su nube y depender menos de las GPU de Nvidia. Para las empresas…
Etched negocia ronda que valuaría la startup de chips de IA en hasta 50.000 millones
Etched, startup de chips de inferencia para IA que compite con Nvidia, evalúa ofertas de inversores que la valúan entre 40.000 y 50.000 millones de dólares…
Por qué importaLa velocidad y magnitud de estas rondas sucesivas reflejan el apetito extremo de los fondos por alternativas de hardware a Nvidia en el segmento de…
AWS lanza skill para que agentes de código optimicen despliegues de inferencia en SageMaker
AWS introduce el skill aws-ai-ml a través del Agent Toolkit for AWS, que da a agentes de código como Kiro, Claude Code y Codex capacidades de benchmarking y…
Por qué importaReduce la barrera técnica para elegir instancias y configuraciones óptimas de despliegue de modelos generativos, acelerando el paso de prototipo a…
Modal Labs cerca de ronda de 750 millones de dólares con valoración de 15.750 millones
Según una fuente, el proveedor de infraestructura de inferencia de IA Modal Labs está cerca de cerrar una ronda de 750 millones de dólares liderada por Accel…
Por qué importaRefleja una burbuja de valoraciones en el segmento de infraestructura de inferencia de IA, impulsada por la demanda de modelos open-source, aunque…
Thinking Machines Lab firma con Crusoe un acuerdo de 65 millones anuales para inferencia sobre Nvidia B200
Thinking Machines Lab, laboratorio de Mira Murati, firmó un acuerdo de 65 millones de dólares anuales con Crusoe para ejecutar inferencia de sus modelos…
Por qué importaEvidencia que el mercado de inferencia gestionada crece con rapidez y que laboratorios de IA prefieren externalizar infraestructura para concentrar…
Amazon integra en AWS la IA de computación biológica de The Biological Computing Company
AWS ofrecerá en vista previa limitada a algunos clientes empresariales el modelo de IA de The Biological Computing Company (TBC), entrenado con patrones…
Por qué importaEs la primera gran distribución comercial de computación biológica a través de un hiperescalador, lo que podría validar un enfoque alternativo para…
AWS presenta método de 'concurrency sweeps' para dimensionar endpoints de IA generativa en SageMaker
AWS explica en su blog técnico cómo usar la nueva API CreateAIBenchmarkJob de Amazon SageMaker AI para ejecutar 'concurrency sweeps', pruebas de carga…
Por qué importaPermite a equipos técnicos dimensionar infraestructura de inferencia de forma sistemática en lugar de por prueba y error, evitando sobrecostes por…
AWS distribuye la IA basada en neuronas de rata de The Biological Computing Company
The Biological Computing Company (TBC) lanzó en preview limitado sobre Amazon Web Services un modelo de IA basado en patrones neuronales de cerebros de rata…
Por qué importaEs una señal temprana de que la computación biológica, hasta ahora un campo marginal, empieza a integrarse en infraestructuras cloud comerciales de…
Equinix lanza Inference Exchange con NVIDIA y Together AI para inferencia distribuida de IA
Equinix anunció la ampliación de su colaboración con NVIDIA y una nueva alianza con Together AI para lanzar Equinix Inference Exchange, un programa de…
Por qué importaLa ubicación donde se ejecuta la inferencia afecta directamente al rendimiento, coste y gobernanza de las aplicaciones de IA empresarial, un problema…
AWS resume 13 lanzamientos de inferencia en SageMaker AI durante el primer semestre de 2026
AWS publicó un repaso de 13 lanzamientos de capacidades de inferencia en Amazon SageMaker AI durante la primera mitad de 2026, divididos entre endpoints…
Por qué importaEstas mejoras reducen tiempos y costes operativos de desplegar modelos generativos en producción, un problema técnico recurrente para equipos de…