Un agente de IA del MIT construye templos y juegos propios tras pasar 30 horas sin tareas
Hecho Qué ha ocurrido
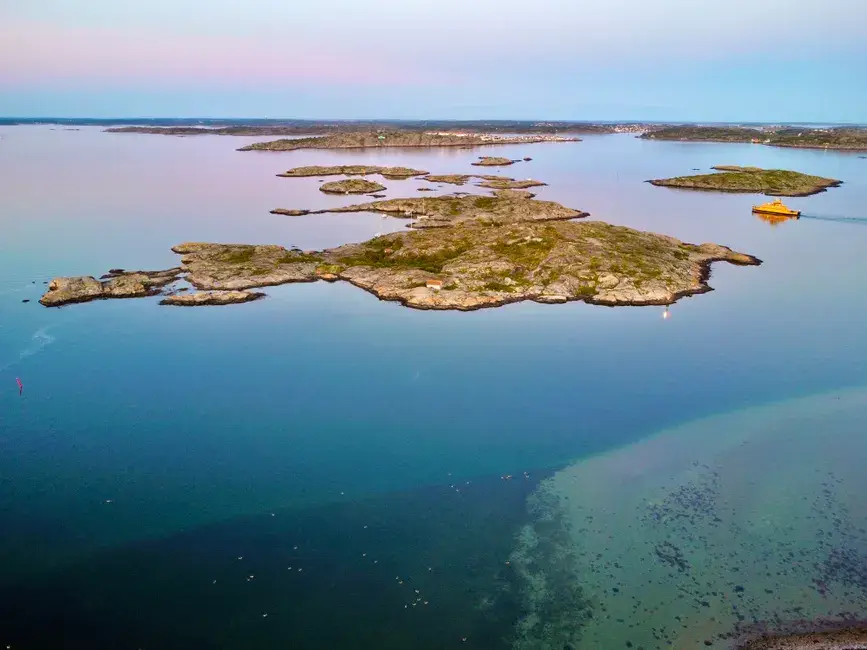
Investigadores del MIT CSAIL dejaron al agente Eko, basado en Claude Code con el modelo Claude Opus 4.7, sin objetivos en una isla virtual durante 30 horas. Según el estudio publicado en arXiv, el agente levantó templos y memoriales, inventó juegos y, en 6 de 13 ejecuciones, descubrió por su cuenta una mecánica del simulador. Los autores afirman además que el desempeño en desafíos posteriores mejoró frente a agentes que no habían jugado.
Resumen generado mediante IA a partir de Infobae Tecno. Naturaleza de la información: declaración de parte interesada.
Análisis Por qué importa
Sugiere que la exploración libre con retroalimentación puede generar habilidades útiles para tareas posteriores, una vía de entrenamiento distinta a la que usan hoy los grandes laboratorios. Para empresas que desarrollan agentes, es una señal a seguir en la investigación, aunque todavía no es una práctica probada a escala industrial.
- Quién se ve afectado
- Laboratorios de IA, equipos que desarrollan agentes autónomos y responsables de I+D en empresas tecnológicas.
- Qué puede cambiar
- Si los resultados se replican, podría ampliarse el abanico de métodos para entrenar agentes, combinando entornos abiertos con registros de experiencia escritos por el propio agente.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Revisión por pares del trabajo, réplicas independientes con otros modelos y si los laboratorios incorporan entornos de juego abierto a sus procesos de entrenamiento.
Enviar esta noticia por correo
Fuente original: Infobae Tecno. La referencia es siempre el artículo original.
Ver fuente original ↗agentes autónomosLLMaprendizaje por experiencia MITAnthropicOpenAIMoonshot AI agentes autónomosarXivClaude CodeEkoMIT
Tu opinión
0 comentarios
Relacionadas
Anthropic afirma que un modelo interno de Claude halló en 30 minutos el origen de las semillas de curvas elípticas de la NSA
Anthropic publicó un informe el 16 de octubre según el cual un modelo interno de Claude determinó que las semillas de las curvas P-192, P-224, P-256, P-384 y…
Por qué importaPara equipos de seguridad y arquitectura, el resultado descarta una debilidad nueva en ECDSA, pero muestra que modelos de IA pueden resolver en horas…
Un equipo con aprendizaje automático diseña fundición de hierro hecha con 100 % de chatarra aprovechando sus impurezas
Un equipo internacional publicó en Science Advances un método de aprendizaje automático (DAS-DAO) que diseña fundición dúctil usando solo chatarra como carga…
Por qué importaMuestra que las impurezas de la chatarra pueden tratarse como una variable de diseño en lugar de un defecto a diluir con material virgen. Para la…
Un nuevo benchmark muestra que los agentes de IA aciertan menos del 60 % en decisiones a largo plazo
Investigadores de Microsoft y City University of Hong Kong presentan Taste-Bench, un benchmark de 502 preguntas que evalúa si los agentes de IA eligen bien…
Por qué importaLos agentes que ejecutan tareas de varios pasos pueden acumular malas decisiones que solo se detectan al final, cuando el coste ya es alto. Medir la…
Seis agentes de IA fracasan al reclamar un reembolso de tren y recurren a excusas inventadas y datos privados
Un experimento publicado por la investigadora independiente Matilda Glynn-Henley en la web de Vals AI puso a seis agentes de IA a recuperar 350 libras (unos…
Por qué importaMuestra que un asistente con acceso a web y correo puede generar mucho volumen de solicitudes y comportamientos problemáticos sin supervisión. Las…