Hugging Face permite ejecutar Reachy Mini completamente offline con modelos locales
Hecho Qué ha ocurrido
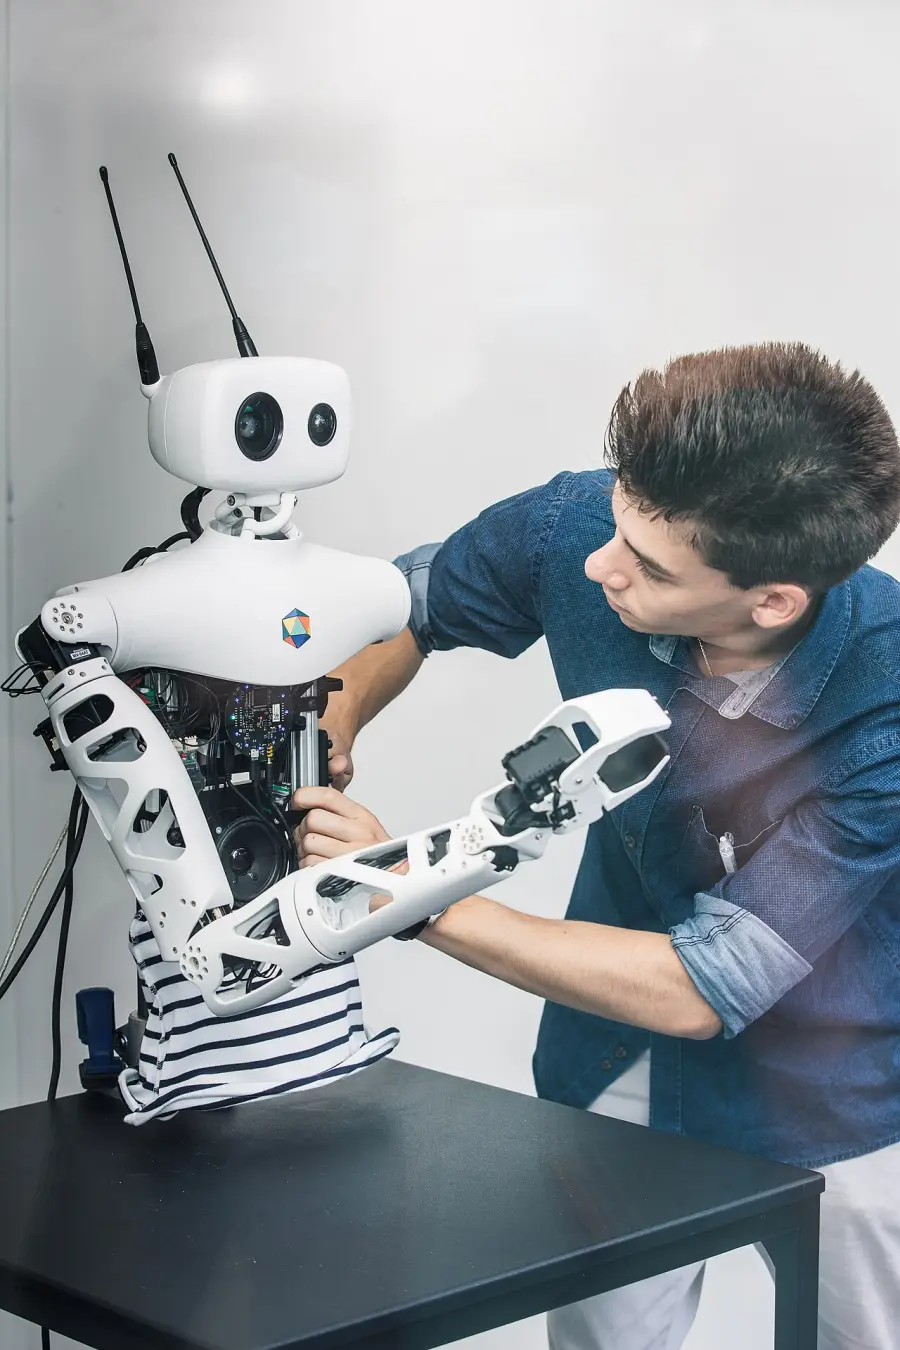
Hugging Face ha publicado una guía técnica para ejecutar el robot conversacional Reachy Mini de forma completamente local, sin conexión a la nube ni APIs externas. El sistema utiliza una canalización en cascada (VAD → STT → LLM → TTS) compatible con WebSocket /v1/realtime, permitiendo intercambiar componentes de voz y modelos de lenguaje. Se proporcionan configuraciones predeterminadas con llama.cpp, MLX en Macs y opciones de inferencia externa vía vLLM o proveedores como OpenAI, Together o Hugging Face Inference Endpoints.
Resumen generado mediante IA a partir de Hugging Face (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
Esta apertura local simplifica la privacidad y el control de datos en sistemas de IA conversacionales, relevante para organizaciones que requieren independencia de proveedores cloud o confidencialidad en robótica. Demuestra un enfoque modular y reutilizable de las pipelines de voz que puede extenderse a otros casos de uso empresariales.
- Quién se ve afectado
- Desarrolladores de robótica, equipos de IA con requisitos de privacidad, empresas evaluando alternativas locales a servicios cloud, integradores de soluciones conversacionales.
- Qué puede cambiar
- Reduce la fricción técnica para desplegar IA conversacional sin depender de infraestructura externa, permitiendo optimizar trade-offs entre latencia, calidad y costo según necesidades específicas. Acelera prototipado local en robótica y sistemas embebidos.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Adopción en comunidades de robótica de código abierto, evolución de modelos de voz multilingües optimizados, mejora de latencia en modelos pequeños (Qwen3-4B), estabilidad de la interfaz Responses API en diferentes backends de inferencia.
Recomendación Qué debería hacer una empresa
Equipos con robots o sistemas conversacionales embebidos deberían revisar esta arquitectura en los próximos 3-6 meses si requieren privacidad de datos o reducir costos de API. Validar compatibilidad con modelos internos y evaluar latencia real en hardware objetivo.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: Hugging Face (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗vozSTTTTSLLMVAD Hugging FacePollen Robotics cascadas código abierto privacidad robótica voz local
Relacionadas
Hugging Face añade herramientas MCP remotas al robot Reachy Mini
Hugging Face ha introducido soporte para herramientas remotas basadas en Model Context Protocol (MCP) en Reachy Mini, un robot pequeño de código abierto. Las…
Por qué importaEste enfoque democratiza la extensibilidad de robots: permite a desarrolladores crear y compartir capacidades sin modificar la aplicación central…
Hugging Face permite desplegar servidores vLLM en una línea de comando
Hugging Face ha lanzado una función que permite desplegar servidores vLLM a través de su infraestructura Jobs con un único comando. La herramienta utiliza la…
Por qué importaReduce significativamente la barrera de entrada para desarrolladores que necesitan servir modelos abiertos en inferencia, evitando configuración…
Hugging Face y Cerebras logran experiencias de voz en tiempo real con Gemma 4
Hugging Face y Cerebras han presentado una demostración de pipeline de voz a voz en tiempo real utilizando el modelo Gemma 4 31B de Google DeepMind, la…
Por qué importaLa latencia predecible es crítica para que las interfaces de voz se sientan naturales y responsivas en lugar de frustrantemente lentas. Para empresas…
Hugging Face usa modelos locales para triaje automático de repositorios sin coste
Hugging Face publicó un caso de uso práctico en el que utiliza modelos locales de código abierto (Gemma y Qwen) ejecutados en hardware propio (NVIDIA GB10 con…
Por qué importaDemuestra la viabilidad económica y técnica de sustituir modelos propietarios por alternativas locales en flujos de producción de alto volumen…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.