Tecnología
TTS
La síntesis de texto a voz (TTS) convierte texto en habla natural, permitiendo clonar voces, diseñar perfiles vocales mediante prompts y generar audio en tiempo real para múltiples idiomas. Se usa en asistentes de voz, doblaje, accesibilidad, atención al cliente y contenido multimedia.
Sobre esta tecnología, IA para hoy ha analizado 12 noticias, procedentes de 6 medios distintos. En los últimos siete días han sido 2, frente a las 0 de la semana anterior. La fiabilidad media de esa cobertura es de 3,4 sobre 5, medida con las reglas de nuestro método. Las áreas de impacto que más se repiten son Operaciones, Atención al cliente, Desarrollo. Aparece en 8 historias en seguimiento.
Evolución en 16 semanas
El momentum semanal se estima con la misma fórmula que el momentum actual: volumen, aceleración respecto a la semana anterior, diversidad de fuentes e impacto.
Análisis Qué significa para una empresa
- Oportunidades
- Permite crear agentes de voz y asistentes conversacionales en múltiples idiomas, automatizar doblaje y locución de contenido, y reducir costes de producción de audio. La reducción de precios y latencia facilita su integración en productos de atención al cliente y accesibilidad a gran escala.
- Riesgos
- La clonación de voz plantea riesgos de suplantación de identidad y fraude, lo que exige mecanismos de consentimiento y marcado (como SynthID). También existe dependencia de proveedores cloud y competencia entre múltiples modelos y APIs que dificulta elegir una solución estable a largo plazo.
- Qué debería hacer una empresa
- Las empresas con canales de atención al cliente o producción de contenido deberían evaluar en los próximos 6 meses pilotos con TTS comercial o de código abierto, priorizando proveedores con garantías de consentimiento y trazabilidad de voces clonadas.
Análisis generado por IA a partir de las noticias disponibles; actualizado 19 oct.
Relacionadas
AWS ×5voz ×5LLM ×3agentes ×3Google ×3síntesis de voz ×3Hugging Face ×2multimodal ×2clonación de voz ×2Qwen ×2
Historias
AWS publica guías para TTS en SageMaker: autoescalado y streaming de voz
AWS publica guía de despliegue de clonación de voz con Qwen3-TTS en SageMaker
Gemini añade apps conectadas y lanza TTS con clonación de voz
Alibaba lanza Qwen-Audio 3.1 y recorta precios de modelos de audio
Deepgram añade métricas de observabilidad en SageMaker
NVIDIA Magpie TTS multilingüe en pesos abiertos para voz en producción
Análisis de Rokid AI Glasses: gafas inteligentes con IA y pantalla monocroma
Reachy Mini soporta ejecución local de voz conversacional sin cloud
Noticias
AWS explica cómo transmitir voz de baja latencia desde agentes de IA con Kokoro-82M en SageMaker
AWS publica una guía para enviar cada frase de un agente de voz a un modelo Kokoro-82M alojado en SageMaker AI en cuanto se genera, sin esperar a la respuesta…
Por qué importaLa latencia percibida es lo que más pesa en la experiencia de los agentes de voz, y el enfoque por frases reduce el tiempo hasta el primer audio sin…
AWS explica cómo calibrar el autoescalado de un endpoint TTS con Kokoro-82M en SageMaker AI
AWS Machine Learning Blog publica una guía para desplegar el modelo de síntesis de voz Kokoro-82M como contenedor personalizado en un endpoint de Amazon…
Por qué importaPara equipos que operan síntesis de voz propia, un umbral mal estimado puede tanto desperdiciar GPU como incumplir la latencia comprometida sin que…
AWS muestra cómo desplegar clonación de voz en tiempo real con Qwen3-TTS en SageMaker
AWS publicó una guía técnica para desplegar el modelo Qwen3-TTS-12Hz-1.7B-Base, de Alibaba Cloud, en un endpoint en tiempo real de Amazon SageMaker JumpStart…
Por qué importaOfrece a empresas una vía self-hosted para producir voz personalizada sin depender de APIs de pago por carácter, manteniendo control de datos y…
Google integra Adobe, Peloton y Airtable en Gemini y lanza TTS que clona voces en 30 segundos
Google anunció el 23 de septiembre nuevas apps conectadas a Gemini (Adobe, Airtable, Peloton, SeatGeek, Experian, entre otras) y dos modelos de texto a voz…
Por qué importaConsolida a Gemini como hub central de productividad, creatividad y servicios de terceros, y posiciona a Google como competidor directo de ElevenLabs…
Alibaba lanza Qwen-Audio 3.1 y recorta hasta 95% los precios de sus modelos de audio con IA
El equipo Qwen de Alibaba lanzó Qwen-Audio-3.1, un conjunto de cinco modelos para reconocimiento de voz (ASR), síntesis de voz (TTS) e interacción en tiempo…
Por qué importaLos recortes de precio combinados con más capacidades técnicas abaratan la adopción de IA de voz en atención al cliente, asistentes y transcripción a…
Deepgram mejora la observabilidad de modelos de voz en Amazon SageMaker con nuevas métricas
Deepgram ha lanzado dos capacidades de observabilidad para sus modelos de reconocimiento y síntesis de voz desplegados en Amazon SageMaker: métricas de…
Por qué importaLas empresas que ejecutan modelos de IA en contenedores aislados de red enfrentan un dilema entre seguridad y visibilidad de costes. Esta solución…
NVIDIA lanza Magpie TTS multilingüe en pesos abiertos para agentes de voz en producción
NVIDIA ha publicado Magpie Multilingual TTS, un modelo de síntesis de voz de pesos abiertos con 364 millones de parámetros que soporta 12 idiomas incluyendo…
Por qué importaPara empresas que construyen agentes de voz en producción, la disponibilidad de un modelo multilingüe de pesos abiertos con bajo control de latencia…
Rokid AI Glasses: análisis de gafas inteligentes con pantalla monocroma y IA integrada
Xataka publica un análisis detallado tras probar durante dos semanas las Rokid AI Glasses, gafas inteligentes con pantalla Micro LED monocroma de 30 grados…
Por qué importaLas gafas inteligentes siguen siendo un formato emergente en busca de adopción masiva; este análisis aporta evidencia práctica sobre la experiencia…
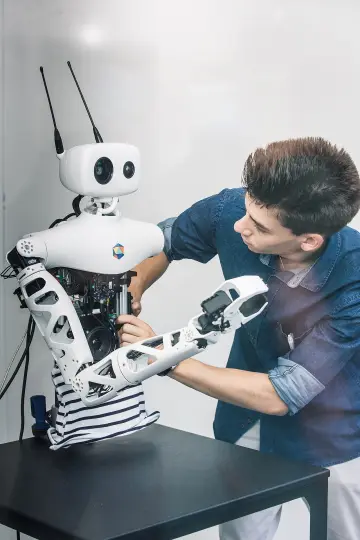
Hugging Face permite ejecutar Reachy Mini completamente offline con modelos locales
Hugging Face ha publicado una guía técnica para ejecutar el robot conversacional Reachy Mini de forma completamente local, sin conexión a la nube ni APIs…
Por qué importaEsta apertura local simplifica la privacidad y el control de datos en sistemas de IA conversacionales, relevante para organizaciones que requieren…
Google lanza Gemini 3.1 Flash TTS, modelo de síntesis de voz dirigible por prompts
Google ha lanzado Gemini 3.1 Flash TTS, un nuevo modelo de texto a voz que permite dirigir la síntesis de audio mediante prompts detallados. El modelo está…
Por qué importaEste enfoque de síntesis de voz dirigible por prompts amplía significativamente las capacidades de personalización en generación de audio…
Amazon Polly lanza API de streaming bidireccional para síntesis de voz en tiempo real
AWS anunció el nuevo Bidirectional Streaming API para Amazon Polly, que permite enviar y recibir texto y audio simultáneamente en aplicaciones…
Por qué importaReduce significativamente la latencia en asistentes virtuales y aplicaciones con LLM, permitiendo que usuarios escuchen respuestas mientras se…
FluentVox: paquete Laravel para síntesis de voz con clonado y aceleración GPU
Se ha lanzado FluentVox, un paquete para Laravel que integra síntesis de voz (TTS) mediante el motor Chatterbox de Resemble AI. El paquete ofrece una API…
Por qué importaSimplifica la integración de síntesis de voz de calidad en aplicaciones PHP/Laravel, reduciendo la fricción típica en implementaciones TTS modernas…