Investigadores buscan hacer la IA más eficiente estudiando cómo aprenden los niños
Hecho Qué ha ocurrido
Investigadores de universidades como MIT, Stanford y Princeton, respaldados por laboratorios como Meta, estudian cómo optimizar modelos de IA replicando mecanismos de aprendizaje infantil. Mientras los modelos actuales requieren billones de tokens para entrenar, un niño domina el lenguaje con apenas cien millones de palabras. La competición BabyLM, iniciada en 2022, demostró en 2024 que un modelo entrenado con solo cien millones de palabras (GPT-BERT) superó a Llama 2 70B en algunas pruebas, entrenado con quince mil veces más datos.
Resumen generado mediante IA a partir de Business Insider España. Naturaleza de la información: hecho documentado.
Análisis Por qué importa
Resolver la brecha de eficiencia de datos es crítico ante el agotamiento previsible de datos textuales en internet en la próxima década. Un enfoque basado en eficiencia en lugar de escala podría reducir drásticamente los costes de entrenamiento y hacer la IA más sostenible y accesible para empresas sin recursos masivos.
- Quién se ve afectado
- Laboratorios de investigación, empresas de IA, universidades; indirectamente, cualquier organización que desarrolle o consuma modelos de lenguaje.
- Qué puede cambiar
- Si se logra transferir principios de aprendizaje infantil (aprendizaje multimodal, interactivo y contextual) a arquitecturas de IA, podría reducirse significativamente el coste computacional del entrenamiento y cambiar el paradigma de escalabilidad que ha dominado la última década.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Evolución de la competición BabyLM y otros benchmarks de eficiencia; publicaciones de Meta, Google DeepMind y OpenAI sobre modelos multimodales entrenados con menos datos; disponibilidad de nuevos datasets de aprendizaje infantil; adopción de estos principios en arquitecturas post-transformer.
Recomendación Qué debería hacer una empresa
Directivos de laboratorios de IA deben evaluar en los próximos 6-12 meses la viabilidad de incorporar mecanismos de aprendizaje activo y multimodal en nuevas arquitecturas, especialmente si operan con presupuestos limitados o buscan reducir la huella ambiental del entrenamiento.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: Business Insider España. La referencia es siempre el artículo original.
Ver fuente original ↗LLMmultimodaltransformervisión por computadora MetaGoogle DeepMindOpenAIUniversidad de StanfordUniversidad de Princeton aprendizaje infantil BabyLM eficiencia de datos modelos de lenguaje sostenibilidad
Relacionadas
DeepMind: modelos más pequeños con más datos superan a gigantes en eficiencia
DeepMind publicó un análisis empírico sobre el entrenamiento óptimo de modelos de lenguaje, concluyendo que los LLM actuales son demasiado grandes para su…
Por qué importaEste hallazgo desafía la estrategia dominante de maximizar parámetros y establece que la proporción óptima es 4x menos parámetros con 4x más datos…
Investigadores desarrollan prueba de aprendizaje basada en bebés para mejorar modelos de visión-lenguaje
Investigadores de Meta, Stanford, Universidad de Tokio y École Normale Supérieure desarrollaron EgoBabyVLM, una prueba que evalúa cómo los modelos de…
Por qué importaEste enfoque revela una brecha crítica en la arquitectura actual de los transformadores: no capturan el aprendizaje multimodal, táctil y contextual…
Google presenta LearnLM, modelo de IA educativo con enfoque socrático para aulas
Conchita Díaz, directiva de Google, presenta LearnLM, un modelo de IA específicamente entrenado con pedagogos para actuar como tutor socrático en las aulas. El…
Por qué importaRepresenta una apuesta clara de un gigante tecnológico por redefinir el papel de la IA en educación, enfatizando la complementariedad con docentes en…
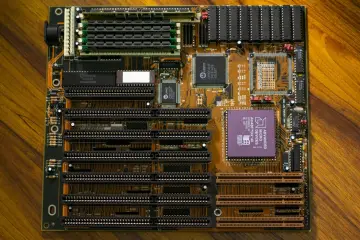
Demuestran que modelos de IA funcionan con solo 128 MB de RAM en procesadores de 1997
Investigadores liderados por Andrej Karpathy y EXO Labs ejecutaron un modelo basado en Llama 2 en una computadora con procesador Pentium II de 350 MHz y 128 MB…
Por qué importaDemuestra que la IA puede democratizarse en hardware antiguo o de bajo costo, reduciendo la dependencia de infraestructura cara y abriendo nuevas…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.