NASA demuestra por primera vez un modelo de lenguaje de Google analizando imágenes en órbita
Hecho Qué ha ocurrido
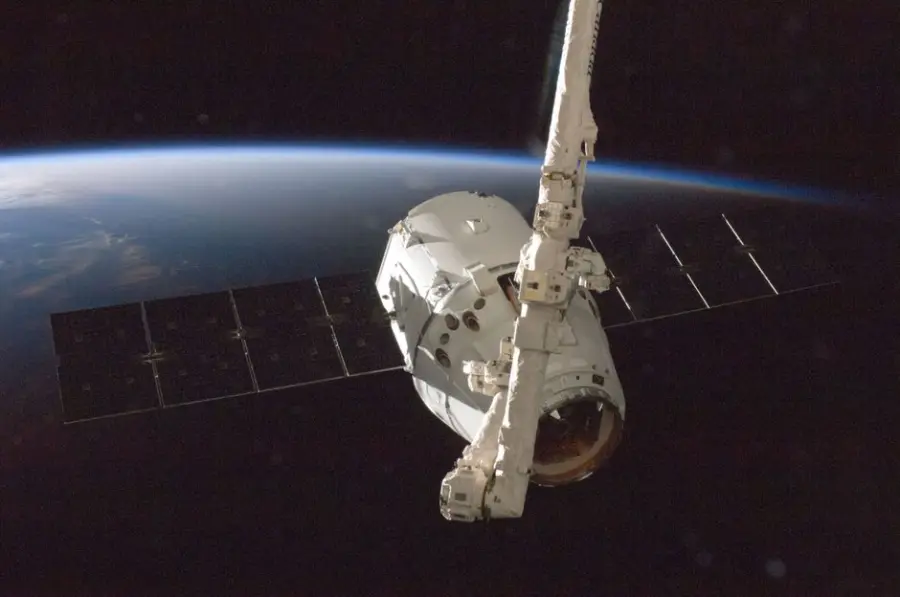
NASA-JPL lanzó Google Gemma 3 en un satélite YAM-9 de Loft Orbital, logrando la primera demostración en órbita de un modelo visión-lenguaje analizando imágenes del propio sensor satelital. El sistema NAVI-Orbital alcanzó 88% de precisión clasificando 7.960 imágenes sin entrenamiento previo, usando una versión comprimida de 4 bits de Gemma 3 4B en un Nvidia Jetson Orin AGX con solo 8 GB de memoria. Los investigadores realizaron pruebas en vivo sobre Toulouse y la costa argentina, permitiendo a científicos escribir prompts de texto para interactuar con la nave en lugar de comandos estructurados.
Resumen generado mediante IA a partir de IEEE Spectrum AI (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
Elimina la brecha entre operación satelital tradicional y acceso a datos en tiempo real, reduciendo latencias de hasta 90 minutos en aplicaciones críticas como detección de incendios. Demuestra que modelos capaces pueden ejecutarse en hardware de bajo consumo en órbita, comprimiendo megabytes de imágenes en kilobytes de resúmenes textuales, transformando la viabilidad económica y operativa de satélites tácticos.
- Quién se ve afectado
- Agencias espaciales, operadores satelitales comerciales, equipos de Earth observation, y sectores que requieren alertas rápidas (emergencias, agricultura, recursos naturales).
- Qué puede cambiar
- Las operaciones satelitales podrían pasar de flujos de datos masivos diferidos a análisis semántico en tiempo real a bordo, permitiendo reconfiguración rápida de objetivos mediante prompts naturales sin redeploy de software crítico. La cadena de valor de datos satelitales se simplifica: menos ancho de banda, menos procesamiento en tierra, más autonomía orbital.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Adopción de este patrón en constelaciones satelitales comerciales (Loft, Planet, others); mejoras en eficiencia energética de modelos comprimidos en órbita; estándares de interfaz natural para control de naves; extensión a casos de uso más allá de imagen (vídeo, sensores multiespectrales). Señales regulatorias sobre autonomía de IA en sistemas críticos espaciales.
Recomendación Qué debería hacer una empresa
Operadores satelitales y empresas de EO deben evaluar en 6-12 meses cómo integrar este patrón en sus pipelines operativos y analizar el ahorro en costes de downlink y latencia versus inversión en hardware de borde en órbita.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: IEEE Spectrum AI. La referencia es siempre el artículo original.
Ver fuente original ↗LLMvision-language modelcompresión 4-bitedge AIagentes NASA Jet Propulsion LaboratoryGoogleLoft OrbitalNvidia análisis de imágenes Gemma 3 NASA operaciones espaciales satélites
Relacionadas
Gemma 4 VLA se ejecuta en Jetson Orin Nano Super con visión multimodal
NVIDIA ha publicado un tutorial demostrando cómo ejecutar Gemma 4, un modelo de agente visual de lenguaje (VLA), en hardware de bajo consumo Jetson Orin Nano…
Por qué importaDemuestra que los agentes multimodales sofisticados pueden ejecutarse de forma eficiente en dispositivos edge con restricciones severas de memoria y…
NVIDIA y Google optimizan Gemma 4 para IA agencial local en GPUs RTX
Google y NVIDIA han colaborado para optimizar la familia Gemma 4 de modelos de código abierto en GPUs de NVIDIA, con variantes de 2B, 4B, 26B y 31B parámetros…
Por qué importaMarca un hito en la carrera por la IA local y de bajo coste: modelos potentes ejecutándose sin dependencia de APIs en la nube, con latencia cercana a…
Google DeepMind presenta Gemma 4 12B: modelo multimodal sin codificadores para portátiles
Google DeepMind ha lanzado Gemma 4 12B, un modelo multimodal diseñado para ejecutarse localmente en portátiles con 16GB de RAM. El modelo adopta una…
Por qué importaDemocratiza la IA multimodal avanzada llevándola a dispositivos de consumo sin dependencia de servidores en la nube, reduciendo latencia y costes…
AWS y Bedrock Robotics usan modelos de visión para anotar datos de construcción autónoma
Bedrock Robotics, mediante el AWS Physical AI Fellowship, utilizó modelos de visión-lenguaje (VLM) para analizar millones de horas de video de construcción y…
Por qué importaLa anotación automática de datos es un cuello de botella crítico en la IA física; resolver este desafío mediante VLM permite desplegar sistemas…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.