Demuestran que modelos de IA funcionan con solo 128 MB de RAM en procesadores de 1997
Hecho Qué ha ocurrido
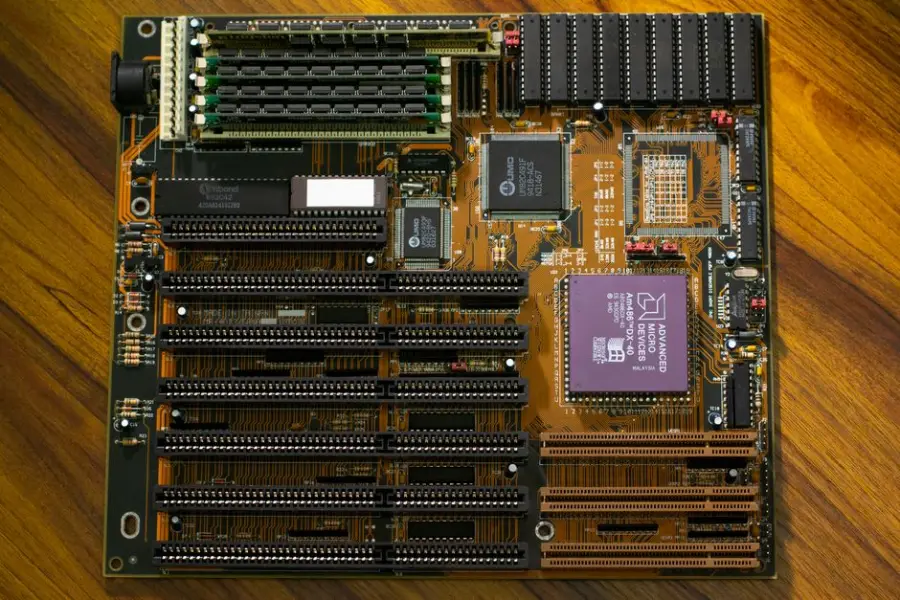
Investigadores liderados por Andrej Karpathy y EXO Labs ejecutaron un modelo basado en Llama 2 en una computadora con procesador Pentium II de 350 MHz y 128 MB de RAM, alcanzando 39 tokens por segundo. La hazaña se logró mediante BitNet, una arquitectura con pesos ternarios que comprimió un modelo de 7 mil millones de parámetros a solo 1,38 GB, priorizando CPU en lugar de tarjetas gráficas especializadas.
Resumen generado mediante IA a partir de Xataka México. Naturaleza de la información: hecho documentado.
Análisis Por qué importa
Demuestra que la IA puede democratizarse en hardware antiguo o de bajo costo, reduciendo la dependencia de infraestructura cara y abriendo nuevas posibilidades para integrar IA en dispositivos limitados, algo relevante para mercados emergentes y empresas con restricciones presupuestarias.
- Quién se ve afectado
- Empresas con infraestructura heredada, mercados emergentes con acceso limitado a hardware moderno, desarrolladores y startups con presupuestos ajustados, sector de IoT y dispositivos embebidos.
- Qué puede cambiar
- Si se consolida, podría permitir que modelos de IA funcionen en dispositivos de bajo costo sin dependencia de GPUs costosas, facilitando su integración en más contextos y reduciendo barreras de entrada para adopción empresarial masiva.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Evolución de BitNet hacia modelos productivos con mayor velocidad y precisión aceptable; adopción por startups y empresas en economías emergentes; mejora en eficiencia de CPU para inferencia; posible estandarización de arquitecturas ternarias en la industria.
Recomendación Qué debería hacer una empresa
Empresas con operaciones en mercados emergentes o con infraestructura limitada deberían evaluar en los próximos 6-12 meses modelos optimizados con BitNet para casos de uso de bajo consumo (procesamiento de texto, análisis básico) antes de invertir en infraestructura GPU tradicional.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: Xataka México. La referencia es siempre el artículo original.
Ver fuente original ↗LLMBitNetpesos ternariosLlama 2inferencia en CPU EXO LabsMeta BitNet democratización eficiencia hardware limitado IA de bajo costo
Relacionadas
Taalas ejecuta Llama 3.1 8B a 17.000 tokens por segundo con hardware personalizado
Taalas, startup de hardware canadiense, anunció su primer producto: una implementación de hardware personalizado de Llama 3.1 8B capaz de ejecutarse a 17.000…
Por qué importaRepresenta un avance significativo en inferencia optimizada: acelera dramáticamente la velocidad de respuesta de modelos de tamaño mediano mediante…
Cómo ejecutar un modelo de lenguaje en tu ordenador personal
Wired publica una guía sobre la instalación y ejecución local de modelos de lenguaje (LLM) en computadoras personales usando software gratuito como LM Studio…
Por qué importaLa ejecución local de LLM permite a usuarios y empresas acceder a capacidades de IA sin enviar datos a la nube, evitando costes de suscripción y…
Gigabyte presenta ecosistema de IA local para escritorio con sistemas AI TOP y memoria DDR5-7200
Gigabyte anunció en el CES 2026 una estrategia integral de hardware para ejecutar inteligencia artificial en equipos locales sin depender de servidores en la…
Por qué importaEsta propuesta redefine cómo las empresas pueden desplegar IA privada, con baja latencia y control total del dato, sin depender de terceros. Para…
DeepMind: modelos más pequeños con más datos superan a gigantes en eficiencia
DeepMind publicó un análisis empírico sobre el entrenamiento óptimo de modelos de lenguaje, concluyendo que los LLM actuales son demasiado grandes para su…
Por qué importaEste hallazgo desafía la estrategia dominante de maximizar parámetros y establece que la proporción óptima es 4x menos parámetros con 4x más datos…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.