OpenAI y Broadcom presentan Jalapeño, chip personalizado para inferencia de LLM
Hecho Qué ha ocurrido
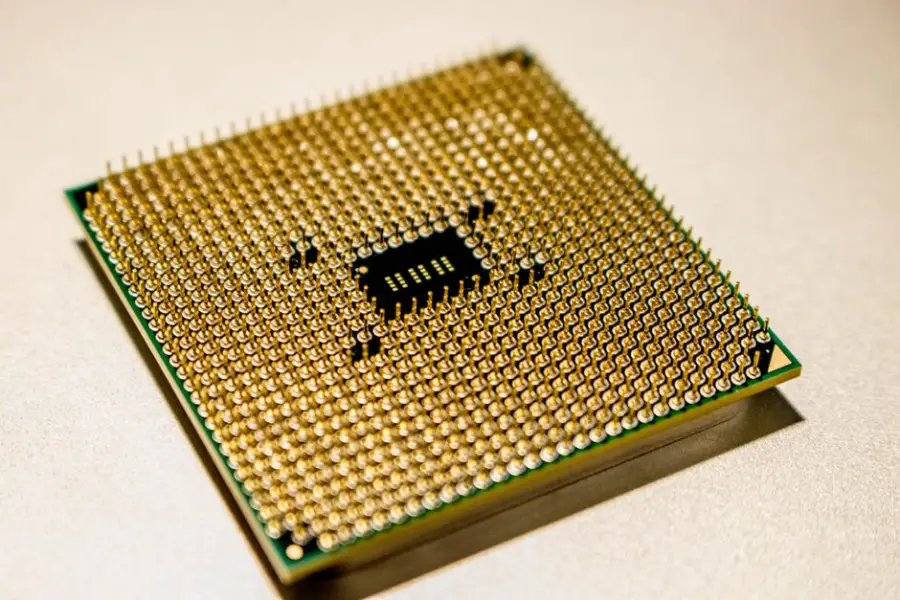
OpenAI y Broadcom han presentado Jalapeño, un chip de IA personalizado diseñado específicamente para optimizar la inferencia de modelos de lenguaje grandes. El chip busca mejorar el rendimiento, la eficiencia energética y la escalabilidad de los sistemas de IA.
Resumen generado mediante IA a partir de OpenAI (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
El desarrollo de chips propios optimizados para inferencia es estratégico para reducir costes operativos y latencias en servicios de IA. Esto permite a OpenAI reducir dependencia de fabricantes de chips convencionales y competir mejor en eficiencia con otros laboratorios.
- Quién se ve afectado
- Proveedores de infraestructura de IA, empresas que operan LLM en producción, competidores como Google y Meta, y clientes de servicios de IA que se beneficiarían de menor latencia y costes.
- Qué puede cambiar
- Si la adopción se generaliza, la arquitectura de inferencia en la nube podría migrar hacia chips especializados, presionando a fabricantes como Nvidia en el segmento de inferencia y reduciendo costes operacionales de los laboratorios. Los tiempos de respuesta de aplicaciones basadas en LLM podrían mejorar significativamente.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Fechas de disponibilidad comercial del chip, adopción en centros de datos de OpenAI y terceros, rendimiento comparado con GPU estándar (A100, H100), presión competitiva de otros chips personalizados (Google TPU, Meta MTIA), y reacción de Nvidia al mercado de inferencia.
Recomendación Qué debería hacer una empresa
Las empresas que operan LLM a escala deben evaluar en los próximos 6-12 meses si la migración a chips especializados como Jalapeño reduce significativamente costes de inferencia y latencias comparado con infraestructura actual; si es así, valorar transición gradual de cargas críticas.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: OpenAI (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗LLMchipsinferencia OpenAIBroadcom Broadcom chips inferencia Jalapeño OpenAI
Relacionadas
OpenAI presenta Jalapeño, su chip propio de inferencia con mayor eficiencia
OpenAI ha anunciado los primeros resultados de Jalapeño, un chip personalizado diseñado para inferencia de IA. Según la compañía, el chip ofrece mayor…
Por qué importaQue OpenAI desarrolle su propio silicio reduce su dependencia de proveedores externos como Nvidia y podría abaratar los costes de servir sus modelos…
OpenAI diseñó su chip de IA Jalapeño con ayuda de sus propios modelos en solo 20 meses
OpenAI anunció el chip Jalapeño, desarrollado con Broadcom y fabricado por TSMC, que alcanza 13,4 petaflops en 4 bits, 232 GB de memoria HBM y 15,4 TB/s de…
Por qué importaMuestra un caso concreto y verificable de cómo la IA multiplica la productividad de equipos técnicos de élite en ingeniería de hardware, y acelera la…
OpenAI presenta su chip Jalapeño para inferencia, compitiendo con Nvidia en eficiencia
OpenAI presentó en junio su primer procesador de IA llamado Jalapeño, desarrollado con Celestica y Broadcom en menos de un año. Según la compañía, el chip…
Por qué importaEl desarrollo de chips propios por OpenAI marca un giro estratégico clave hacia la reducción de costes de computación e independencia de proveedores…
OpenAI detalla cómo usó sus propios modelos de IA para diseñar el chip Jalapeño en 20 meses
OpenAI presentó Jalapeño, su primer chip acelerador de IA, con 13,4 petaflops en 4 bits y 232 GB de memoria a 15,4 TB/s, y afirma reducir la latencia hasta…
Por qué importaMuestra un caso concreto de cómo los LLMs pueden acelerar drásticamente el diseño de hardware complejo, comprimiendo ciclos que tradicionalmente…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.