DeepMind presenta DeepNash, IA que domina Stratego, juego de información imperfecta
Hecho Qué ha ocurrido
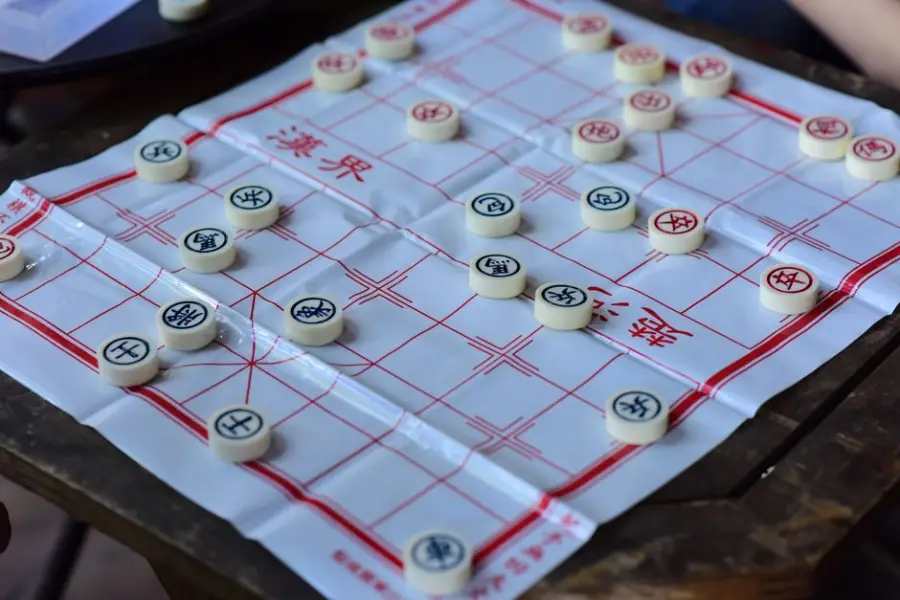
Google DeepMind ha desarrollado DeepNash, un agente de IA que ha alcanzado nivel de experto humano en Stratego, un juego de mesa más complejo que el ajedrez y el Go. DeepNash utiliza una técnica novedosa llamada Regularised Nash Dynamics (R-NaD) que combina teoría de juegos con aprendizaje por refuerzo profundo sin modelo. El sistema logró una tasa de victoria del 84% contra los mejores jugadores humanos en la plataforma Gravon, alcanzando el top-3 de todos los tiempos, y una tasa del 97% contra los mejores bots de Stratego.
Resumen generado mediante IA a partir de Google DeepMind (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
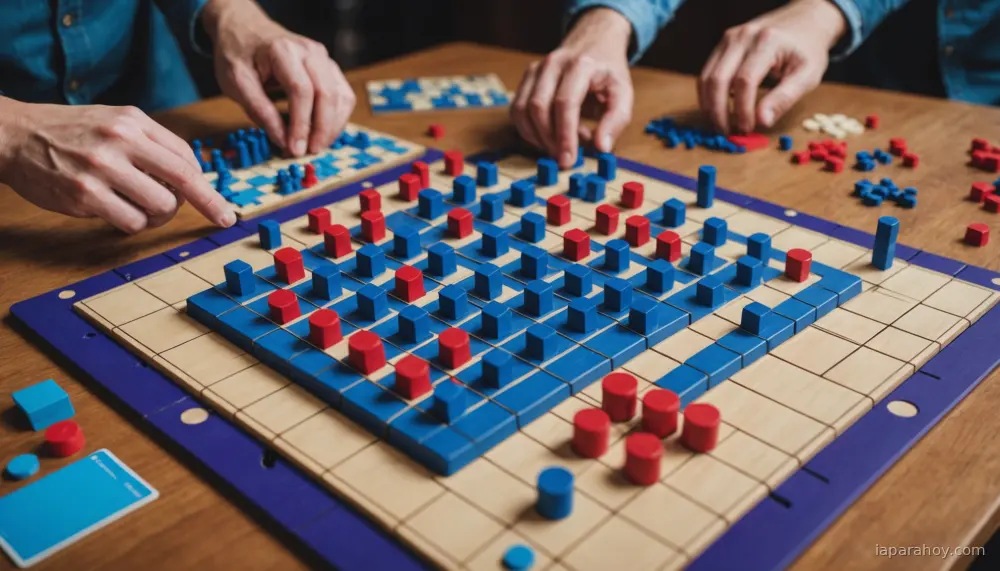
Este avance es significativo porque Stratego representa un desafío técnico diferente a juegos de información perfecta como el ajedrez o el Go: requiere tomar decisiones con información incompleta, hacer bluffs y razonar sobre múltiples movimientos sin claridad sobre cómo cada acción contribuye al resultado. Los métodos desarrollados son aplicables a problemas del mundo real donde los agentes operan con información limitada sobre otros agentes y personas.
- Quién se ve afectado
- Investigadores en IA, especialmente en aprendizaje por refuerzo y teoría de juegos; desarrolladores de sistemas multi-agente; organizaciones que requieren IA para tomar decisiones en entornos con información incompleta.
- Qué puede cambiar
- Si el método R-NaD se generaliza y escala, podría permitir sistemas de IA más robustos y menos explotables en aplicaciones reales complejas donde coexisten múltiples agentes con objetivos potencialmente conflictivos o información asimétrica.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Se debe vigilar si R-NaD es adoptado o reproducido por otros laboratorios; si se publica código abierto o se integra en frameworks de RL; si DeepMind demuestra aplicaciones prácticas en negociación, mercados, sistemas de defensa o planificación multi-agente; y la tasa de adopción académica del método.
Recomendación Qué debería hacer una empresa
Equipos de IA en empresas de finanzas, logística y sistemas multi-agente deberían evaluar en los próximos 6-12 meses si los principios de R-NaD y el juego de información imperfecta pueden adaptarse a sus problemas de optimización o coordinación bajo incertidumbre.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: Google DeepMind (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗aprendizaje por refuerzo profundoteoría de juegosNash equilibrium Google DeepMind DeepNash información imperfecta multi-agente Stratego teoría de juegos
Relacionadas
DeepMind publica método para analizar juegos asimétricos con múltiples agentes IA
Google DeepMind ha publicado en Scientific Reports un nuevo método basado en teoría de juegos para analizar cómo interactúan sistemas IA en situaciones…
Por qué importaA medida que múltiples sistemas IA interactúen en el mundo real—desde robots cooperativos hasta mercados automatizados—entender sus dinámicas…
IA bautizada Ataraxos vence al mejor jugador humano de Stratego por primera vez
Investigadores de Carnegie Mellon, MIT, NYU y Stanford desarrollaron una IA llamada Ataraxos que venció a Pim Niemeijer, considerado el mejor jugador de…
Por qué importaStratego es un juego de información oculta a largo plazo, y resolverlo con un presupuesto modesto muestra que técnicas eficientes pueden superar…
DeepMind cierra etapa competitiva de AlphaGo y anuncia transición a investigación científica
DeepMind anunció en la Cumbre del Futuro del Go en Wuzhen, China, que la Future of Go Summit será el evento competitivo final de AlphaGo. El equipo de…
Por qué importaMarca el cierre de una era de demostraciones competitivas en juegos para pivotear hacia aplicaciones científicas prácticas como descubrimiento de…
DeepMind publica evaluación completa de AlphaZero en Science
Google DeepMind ha publicado en la revista Science la evaluación completa de AlphaZero, el sistema que en 2017 aprendió a dominar ajedrez, shogi y Go desde…
Por qué importaAlphaZero demuestra que un único algoritmo general puede dominar múltiples dominios complejos sin reglas codificadas manualmente, solo con los…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.