Google DeepMind crea método de traducción sin datos pareados usando vídeos
Hecho Qué ha ocurrido
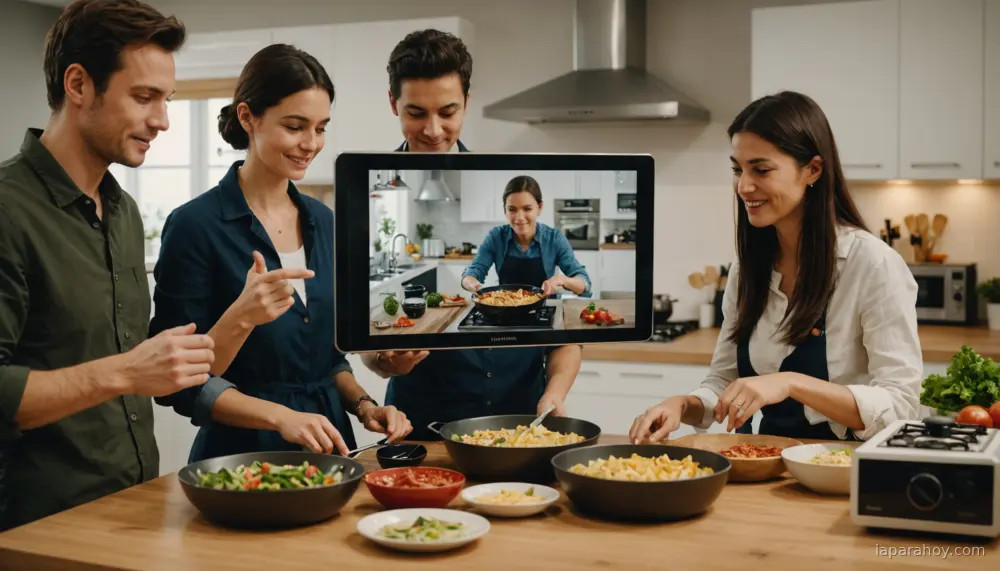
Google DeepMind ha desarrollado MUVE (Multilingual Unsupervised Visual Embeddings), un modelo que traduce palabras entre idiomas sin necesidad de corpus de texto paralelo. El método utiliza vídeos no pareados pero sobre temas similares (p. ej., recetas de pasta en coreano e inglés) para crear un espacio de incrustaciones compartido que vincula palabras en diferentes idiomas a través de similitud visual.
Resumen generado mediante IA a partir de Google DeepMind (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
Abre una vía práctica para traducción entre idiomas que carecen de datos paralelos suficientes, especialmente pares muy distantes como inglés-coreano o inglés-japonés, algo crítico para empresas con operaciones multilingües en mercados emergentes. El enfoque combina visión y lenguaje, reduciendo la dependencia de corpus textuales costosos de alinear.
- Quién se ve afectado
- Empresas de traducción automática, plataformas de e-learning multilingües, creadores de contenido instructivo internacional y organizaciones que operan en mercados sin recursos lingüísticos digitales abundantes.
- Qué puede cambiar
- Podría reducir costos y tiempo de desarrollo de sistemas de traducción para pares de idiomas de bajo recurso, y permitir entrenar modelos de traducción desde vídeos instructivos (tutoriales, documentales) en lugar de esperar alineaciones textuales. También abre aplicaciones en localización de contenido audiovisual.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Adopción en plataformas de traducción comerciales; resultados en benchmarks públicos de traducción sin supervisión (BlissLM u otros); extensión del método a más pares de idiomas y dominios; integración en sistemas de traducción existentes en empresas y editores de contenido.
Recomendación Qué debería hacer una empresa
Empresas de traducción y localización deberían evaluar MUVE en los próximos 6-12 meses para pares de idiomas desafiantes; equipos de contenido internacional podrían pilotear el método en corpus de vídeos internos para reducir costos de localización audiovisual.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: Google DeepMind (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗multimodaltraducción automáticaembedding visualaprendizaje sin supervisión Google DeepMind aprendizaje sin supervisión Google DeepMind traducción multilingüe vídeo visión y lenguaje
Relacionadas
Google DeepMind lanza Gemini 3.5 Live Translate con traducción simultánea de voz
Google DeepMind ha lanzado Gemini 3.5 Live Translate, un modelo de audio que realiza traducción simultánea de voz en más de 70 idiomas con latencia cercana a…
Por qué importaSimplifica significativamente la comunicación multilingüe en reuniones, llamadas y aplicaciones empresariales, eliminando pausas incómodas y…
Google Pixel 11 incorpora traducción automática de lengua de signos a texto en tiempo real
Google ha incluido en la familia Pixel 11 una función de accesibilidad que convierte el lenguaje de signos a texto mediante un modelo de IA llamado SL2T…
Por qué importaEsta funcionalidad representa un avance significativo en accesibilidad digital que elimina barreras de comunicación para personas sordas, permitiendo…
Google DeepMind aprende a identificar objetos por su sonido sin etiquetas
Google DeepMind presenta una investigación sobre aprendizaje audio-visual que permite a redes neuronales entrenar conjuntamente a partir de vídeos sin…
Por qué importaEl aprendizaje multimodal sin supervisión es una dirección clave para entrenar sistemas más eficientes: permite aprovechar el enorme volumen de…
Google DeepMind lanza SL2T, modelo de traducción lengua de signos a texto
Google DeepMind ha presentado SL2T (sign-language-to-text), un modelo de traducción de lenguaje de signos a texto entrenado con más de 100.000 horas de datos…
Por qué importaRepresenta el primer despliegue a escala de consumidor de IA aplicada a lenguas de signos, eliminando una brecha tecnológica histórica entre usuarios…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.