Hugging Face y Cerebras logran experiencias de voz en tiempo real con Gemma 4
Hecho Qué ha ocurrido
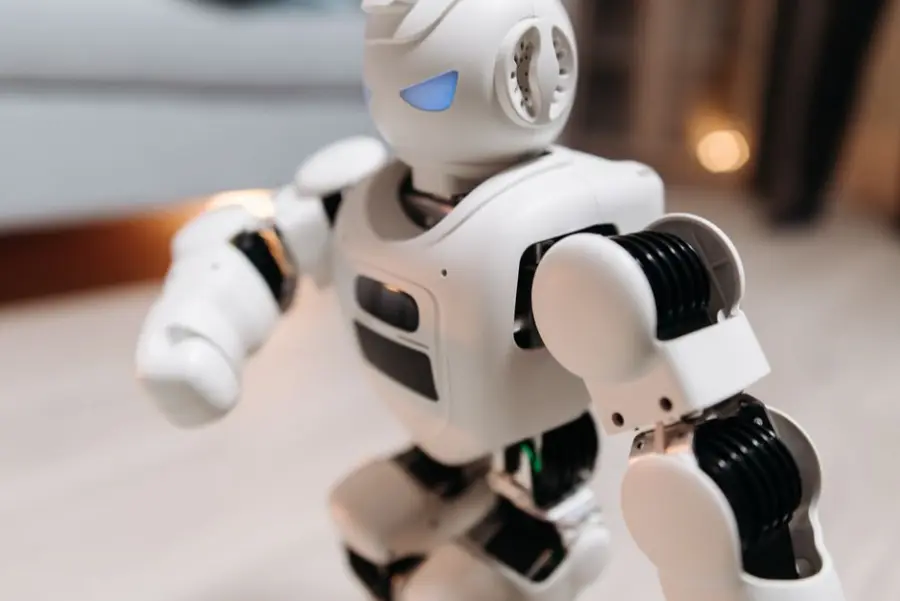
Hugging Face y Cerebras han presentado una demostración de pipeline de voz a voz en tiempo real utilizando el modelo Gemma 4 31B de Google DeepMind, la tecnología de inferencia rápida de Cerebras y el sintetizador de Qwen. El sistema reduce significativamente la latencia en respuestas, permitiendo conversaciones naturales sin los retrasos de varios segundos típicos en sistemas actuales. La arquitectura modular ya alimenta más de 9.000 robots Reachy Mini en funcionamiento.
Resumen generado mediante IA a partir de Hugging Face (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
La latencia predecible es crítica para que las interfaces de voz se sientan naturales y responsivas en lugar de frustrantemente lentas. Para empresas desarrollando asistentes de voz, robots y aplicaciones de IA encarnada, reducir el retraso de respuesta es un cambio que afecta directamente a la experiencia del usuario y la viabilidad comercial de estos productos.
- Quién se ve afectado
- Desarrolladores de asistentes de voz, fabricantes de robots, empresas de soporte al cliente, proveedores de servicios de educación y accesibilidad que integren interfaces conversacionales de audio.
- Qué puede cambiar
- La inferencia rápida y estable de Cerebras permite crear sistemas de voz naturales y fluidos a escala, sin necesidad de compromisos entre latencia e inteligencia del modelo. Esto puede acelerar la adopción de interfaces de voz en robots, vehículos autónomos y espacios públicos.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Adopción de esta arquitectura abierta por otros desarrolladores y fabricantes de hardware; evolución de la latencia en P95 (casos extremos) en sistemas en producción; disponibilidad de optimizaciones para multimodalidad y llamadas a funciones; impacto en casos de uso con múltiples hablantes simultáneos.
Recomendación Qué debería hacer una empresa
Evaluar el repositorio y la demostración de Hugging Face en los próximos 3-6 meses si desarrollas productos con interfaces de voz o robotica; considerar Cerebras como opción de inferencia si la latencia es crítica en tus aplicaciones conversacionales.
Recomendación generada por IA con la evidencia disponible; no es asesoramiento profesional.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: Hugging Face (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗LLMvozspeech-to-speechinferencia en tiempo realrobotica Hugging FaceCerebrasGoogle DeepMindQwen Gemma 4 open source Reachy Mini robots voz en tiempo real
Relacionadas
Google lanza Gemini 3.8 Live, modelos de voz en tiempo real vía WebSockets
Google presentó Gemini 3.8 Live y 3.8 Live Extended Thinking, dos modelos speech-to-speech comparables a la familia GPT-Live de OpenAI. El desarrollador Simon…
Por qué importaLos modelos de voz en tiempo real son clave para asistentes conversacionales y atención al cliente automatizada, y esta demo muestra lo accesible que…
Gemma 4: modelo multimodal abierto con soporte para audio, imagen y vídeo
Google y Hugging Face han lanzado Gemma 4, una familia de modelos multimodales abiertos bajo licencia Apache 2 que procesa imagen, audio y vídeo, con cinco…
Por qué importaGemma 4 ofrece capacidades fronterizas en un modelo completamente abierto y optimizado para dispositivos de consumo, reduciendo la dependencia de…
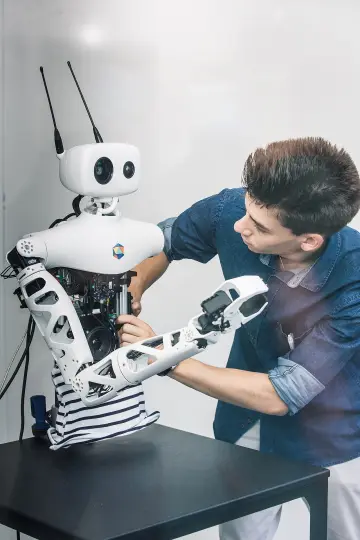
Hugging Face permite ejecutar Reachy Mini completamente offline con modelos locales
Hugging Face ha publicado una guía técnica para ejecutar el robot conversacional Reachy Mini de forma completamente local, sin conexión a la nube ni APIs…
Por qué importaEsta apertura local simplifica la privacidad y el control de datos en sistemas de IA conversacionales, relevante para organizaciones que requieren…
Google DeepMind lanza Gemini 3.8 Live y Live Extended Thinking para voz en tiempo real
Google DeepMind presenta Gemini 3.8 Live y 3.8 Live Extended Thinking, sus modelos de diálogo en vivo más avanzados, disponibles vía API, Google Workspace y…
Por qué importaEstos modelos acercan la voz como interfaz principal para agentes empresariales capaces de ejecutar tareas complejas mientras mantienen conversación…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.