Tecnología
audio
El audio como modalidad de IA permite generar, transcribir, entender y buscar contenido sonoro (voz, música, ruido ambiental), integrado cada vez más en modelos multimodales junto a texto, imagen y vídeo. Sirve para asistentes de voz, transcripción de reuniones, doblaje, detección de contenido falso y búsqueda semántica en archivos sonoros.
Sobre esta tecnología, IA para hoy ha analizado 18 noticias, procedentes de 12 medios distintos. No ha habido cobertura nueva en la última semana. La fiabilidad media de esa cobertura es de 4,2 sobre 5, medida con las reglas de nuestro método. Las áreas de impacto que más se repiten son Desarrollo, IT, Operaciones. Aparece en 8 historias en seguimiento.
Evolución en 16 semanas
El momentum semanal se estima con la misma fórmula que el momentum actual: volumen, aceleración respecto a la semana anterior, diversidad de fuentes e impacto.
Análisis Qué significa para una empresa
- Oportunidades
- Automatización de transcripción y edición de audio/vídeo, asistentes de voz más naturales para atención al cliente, búsqueda semántica en archivos multimedia y nuevos dispositivos controlados por voz sin pantalla.
- Riesgos
- Proliferación de grabaciones y transcripciones sin consentimiento plantea riesgos legales y de privacidad; la detección de deepfakes de audio aún es limitada e inglés-céntrica; dependencia de proveedores (Google, Alibaba, NVIDIA, Apple) con rápida obsolescencia de modelos.
- Qué debería hacer una empresa
- Evaluar en los próximos 6 meses el uso de modelos multimodales de audio (transcripción, búsqueda, asistentes) para procesos internos, estableciendo políticas claras de consentimiento y gestión de grabaciones.
Análisis generado por IA a partir de las noticias disponibles; actualizado 13 oct.
Relacionadas
multimodal ×10LLM ×9Google ×6Google DeepMind ×5video ×5agentes ×4OpenAI ×4vision ×4Nvidia ×3Anthropic ×2
Historias
Google abre al público SynthID Detector para contenido de IA
Estudio revela límites de la IA para interpretar el lenguaje animal
Alibaba lanza Qwen3.8-Omni-Flash con precios muy inferiores a Gemini
Adobe añade generación de vídeo y audio con IA a Premiere y After Effects
Grabaciones automáticas sin consentimiento: dilema ético en apps de transcripción
Thinking Machines Lab lanza Inkling, modelo abierto de 975B parámetros
Lanzamiento de Gemma 4 12B para edge AI multimodal
Nemotron 3 Nano Omni de NVIDIA llega a SageMaker JumpStart
Noticias
Google abre a todo el público su herramienta SynthID Detector para identificar contenido generado con IA
Google lanzó públicamente SynthID Detector, una web que permite a cualquier usuario comprobar si una imagen, video o audio contiene la marca de agua de…
Por qué importaFacilita la verificación de autenticidad de contenido multimedia en un contexto de creciente desinformación generada por IA, aunque su cobertura…
Estudio de Tel Aviv muestra límites de la IA para descifrar el significado del lenguaje animal
Investigadores de la Universidad de Tel Aviv y otras instituciones publicaron en Current Biology un estudio que probó redes neuronales de última generación con…
Por qué importaEl hallazgo cuestiona la promesa de que la IA pueda 'traducir' la comunicación animal solo a partir del análisis acústico, algo relevante para…
Alibaba lanza Qwen3.8-Omni-Flash, modelo multimodal más barato que Gemini Flash
Alibaba presentó Qwen3.8-Omni-Flash, su primer modelo multimodal para agentes de IA, que procesa audio y vídeo conjuntamente con ventana de contexto de un…
Por qué importaOfrece capacidades multimodales similares a un modelo líder de Google a un coste sensiblemente menor, lo que presiona los precios del mercado de IA…
Adobe integra generación de vídeo y audio con IA en la línea de tiempo de Premiere y After Effects
Adobe anunció tres actualizaciones de IA para Premiere Pro y After Effects antes de IBC 2026: una herramienta de 'Medios generativos' que rellena huecos de…
Por qué importaAdobe se posiciona como la capa de flujo de trabajo donde convergen múltiples modelos generativos de vídeo, en lugar de competir directamente como…
El dilema de las grabaciones perpetuas: a quién le importan las transcripciones de reuniones
Un artículo de Wall Street Journal reportado por TechCrunch describe cómo inversores y profesionales recurren a trucos para evitar grabaciones no consentidas…
Por qué importaLa normalización de grabaciones perpetuas sin consentimiento explícito plantea dilemas éticos, legales y prácticos para empresas y profesionales. La…
Thinking Machines Lab lanza Inkling, modelo de 975 mil millones de parámetros de código abierto
Thinking Machines Lab, fundada por antiguos ejecutivos de OpenAI incluida Mira Murati, ha lanzado Inkling, un modelo de código abierto con 975 mil millones de…
Por qué importaInkling representa un desafío competitivo a OpenAI y Anthropic desde un equipo de exiles de alto nivel, validando el modelo de modelos abiertos como…
Google DeepMind presenta Gemma 4 12B: modelo multimodal sin codificadores para portátiles
Google DeepMind ha lanzado Gemma 4 12B, un modelo multimodal diseñado para ejecutarse localmente en portátiles con 16GB de RAM. El modelo adopta una…
Por qué importaDemocratiza la IA multimodal avanzada llevándola a dispositivos de consumo sin dependencia de servidores en la nube, reduciendo latencia y costes…
NVIDIA lanza Nemotron 3 Nano Omni, modelo multimodal unificado para agentes más eficientes
NVIDIA ha presentado Nemotron 3 Nano Omni, un modelo multimodal abierto que integra visión, audio e idioma en una única arquitectura de 30B-A3B con mezcla de…
Por qué importaElimina la ineficiencia de sistemas de agentes que requieren múltiples modelos separados para visión, audio y lenguaje, reduciendo latencia…
NVIDIA presenta Nemotron 3 Nano Omni, modelo multimodal eficiente para documentos, audio y vídeo
NVIDIA ha lanzado Nemotron 3 Nano Omni, un modelo de lenguaje multimodal abierto de 30B parámetros diseñado para procesar documentos largos, audio y vídeo con…
Por qué importaPara empresas que necesitan procesar documentos complejos, vídeos con narración o contenido de audio mixto, este modelo abierto ofrece una…
Amazon Nova Embeddings para búsqueda de audio: guía técnica de implementación
AWS publica un tutorial técnico sobre cómo utilizar Amazon Nova Multimodal Embeddings (lanzado en octubre de 2025) para construir sistemas de búsqueda…
Por qué importaLas organizaciones con grandes librerías de audio (podcasts, música, archivos de llamadas) pueden mejorar significativamente la capacidad de búsqueda…
Gemma 4: modelo multimodal abierto con soporte para audio, imagen y vídeo
Google y Hugging Face han lanzado Gemma 4, una familia de modelos multimodales abiertos bajo licencia Apache 2 que procesa imagen, audio y vídeo, con cinco…
Por qué importaGemma 4 ofrece capacidades fronterizas en un modelo completamente abierto y optimizado para dispositivos de consumo, reduciendo la dependencia de…
Alibaba lanza Qwen3.5-Omni, modelo multimodal que genera código desde instrucciones de voz y vídeo
Alibaba ha lanzado Qwen3.5-Omni, un modelo de IA omnimmodal que procesa texto, imágenes, audio y vídeo. El modelo supera a Gemini 3.1 Pro en tareas de audio y…
Por qué importaLa capacidad emergente de generación de código multimodal (audio-visual) sin entrenamiento específico sugiere que los modelos omnimmodales pueden…
Google lanza Gemini 3.1 Flash Live con mejor comprensión de audio y menor latencia
Google DeepMind ha presentado Gemini 3.1 Flash Live, su modelo de audio y voz de más alta calidad, diseñado para diálogos en tiempo real más naturales y…
Por qué importaLa mejora en comprensión de matices tonales, latencia reducida y capacidad multilingüe hace que la interacción por voz sea más viable para agentes…
Apple adquiere Q.ai por casi 2.000 millones para potenciar audio e IA en dispositivos
Apple ha adquirido Q.ai, una startup israelí especializada en tecnologías de audio e imágenes basadas en machine learning, por un valor de aproximadamente…
Por qué importaEsta es la segunda mayor adquisición de Apple en su historia y refleja su estrategia de integrar IA avanzada en hardware, especialmente en audio y…
AWS amplía Bedrock con búsqueda multimodal nativa en video, audio, imagen y texto
AWS ha anunciado la disponibilidad general de multimodal retrieval para Amazon Bedrock Knowledge Bases, que permite buscar e indexar información en video…
Por qué importaEsta capacidad elimina la necesidad de infraestructura personalizada compleja para construir aplicaciones RAG que procesen múltiples formatos de…
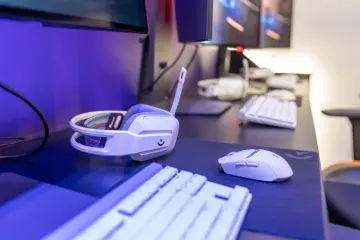
Razer presenta productos IA para gaming: avatar entrenador y auriculares con visión en tiempo real
Razer reveló en el CES 2026 más de seis productos impulsados por inteligencia artificial. Destacan Project AVA, un avatar animado de 5,5 pulgadas que actúa…
Por qué importaRazer materializa la integración de IA en accesorios gaming de consumo masivo, demostrando que la IA ya no es solo backend sino interfaz de…
OpenAI prepara modelo de voz para Q1 2026 y dispositivos sin pantalla para 2027
OpenAI ha unificado equipos de ingeniería, producto e investigación para revolucionar sus modelos de audio, liderada por Kundan Kumar (exinvestigador de…
Por qué importaOpenAI intenta convertir el audio en interfaz principal de interacción, desplazando pantallas a segundo plano en ciertos casos de uso, lo que…
DeepMind presenta Perception Test, benchmark multimodal para evaluar percepción en IA
Google DeepMind ha lanzado el Perception Test, un benchmark basado en videos reales del mundo para evaluar las capacidades perceptivas de modelos de IA…
Por qué importaLos benchmarks son instrumentos clave para definir objetivos de investigación y medir progreso en IA. El Perception Test aborda una brecha…