Tecnología
vision
La visión por computador es la capacidad de los sistemas de IA para interpretar imágenes, vídeo y entornos físicos, integrándose cada vez más con modelos de lenguaje para crear asistentes multimodales y robots capaces de actuar en el mundo real. Permite desde reconocer objetos y documentos hasta controlar robots humanoides o analizar lo que el usuario señala en pantalla.
Sobre esta tecnología, IA para hoy ha analizado 21 noticias, procedentes de 13 medios distintos. No ha habido cobertura nueva en la última semana. La fiabilidad media de esa cobertura es de 3,9 sobre 5, medida con las reglas de nuestro método. Las áreas de impacto que más se repiten son Desarrollo, Automatización, Operaciones. Aparece en 8 historias en seguimiento.
Evolución en 16 semanas
El momentum semanal se estima con la misma fórmula que el momentum actual: volumen, aceleración respecto a la semana anterior, diversidad de fuentes e impacto.
Análisis Qué significa para una empresa
- Oportunidades
- Permite automatizar inspección de calidad, logística y atención al cliente mediante asistentes que ven y razonan sobre imágenes, así como integrar interfaces más naturales (gestos, cámara) en productos y procesos. También abre la puerta a robótica industrial y de servicios más autónoma y flexible.
- Riesgos
- Persisten errores y sesgos relevantes (modelos que inventan o ignoran fallos reales en verificación visual), además de dependencia de proveedores de modelos y hardware específico, y cuestiones de privacidad al procesar imágenes de entornos y personas.
- Qué debería hacer una empresa
- Las empresas con procesos de inspección visual, atención al cliente o logística deberían pilotar en los próximos 6 meses asistentes multimodales ya disponibles (Gemini, Claude, GPT) antes de invertir en robótica física, que aún requiere mayor validación.
Análisis generado por IA a partir de las noticias disponibles; actualizado 19 oct.
Relacionadas
multimodal ×12LLM ×10agentes ×9Google DeepMind ×6OpenAI ×4audio ×4Anthropic ×3Google ×3Meta ×3robótica ×3
Historias
Epoch AI mide progreso de IA con benchmark de montaje de muebles IKEA
CES 2026: IA física y robótica humanoide como nuevo centro de gravedad tecnológico
Dispositivo físico de OpenAI con forma de dona para IA conversacional
Meta lanza Muse Glimmer, modelo abierto de 30B parámetros para agentes
Google lanza Gemini Robotics 2 para robots autónomos
Agility Robotics despliega centro de entrenamiento competitivo ante Tesla
Lanzamiento de Kimi K3: modelo abierto chino de 2,8 billones de parámetros
Anthropic acepta supervisión gubernamental permanente tras suspensión de Fable 5
Noticias
Un benchmark que evalúa la IA verificando montajes de muebles de Ikea sube de 28% a 80% en diez meses
Epoch AI creó el Furniture Assembly Benchmark (FAB), que pide a modelos de IA verificar si muebles de IKEA fueron montados correctamente usando fotos y el…
Por qué importaEl benchmark mide razonamiento abstracto y visión aplicada a instrucciones del mundo real, una capacidad clave para que la IA asista en tareas…
OpenAI presenta dispositivo portátil en forma de dona para interacción con IA
OpenAI avanza en el desarrollo de su primer dispositivo físico, con forma de dona, sin pantalla, alimentado por batería y diseñado como parlante inteligente…
Por qué importaMarca un giro estratégico de OpenAI hacia hardware físico como canal de distribución de IA conversacional, potencialmente más accesible que…
Meta lanza Muse Glimmer: modelo abierto de 30B parámetros optimizado para agentes autónomos
Meta ha lanzado Muse Glimmer, un modelo de lenguaje de 30 mil millones de parámetros bajo licencia Apache 2.0. El modelo está optimizado para tareas agenticas…
Por qué importaLa disponibilidad de un modelo abierto de gran tamaño bajo licencia permisiva (Apache 2.0) reduce la dependencia de APIs propietarias y permite a…
Google presenta Gemini Robotics 2, modelo de IA para robots autónomos con razonamiento
Google DeepMind ha lanzado Gemini Robotics 2, un modelo de inteligencia artificial que permite a los robots analizar su entorno, adaptarse a situaciones…
Por qué importaRepresenta un avance significativo hacia la automatización industrial flexible, donde los robots pueden operar en entornos no estructurados sin…
Agility Robotics abre centro de entrenamiento para robots humanoides en California
Agility Robotics ha inaugurado una instalación de 60.000 pies cuadrados en Fremont, California, para entrenar a sus robots humanoides Digit. El robot ya genera…
Por qué importaMuestra que la robótica humanoides está pasando de investigación a despliegue comercial real, con una empresa estableciendo liderazgo operativo…
Moonshot lanza Kimi K3, modelo abierto de 2,8 billones de parámetros competitivo con Claude y GPT-5.5
Moonshot ha lanzado Kimi K3, un modelo de inteligencia artificial abierto con 2,8 billones de parámetros y ventana de contexto de 1 millón de tokens. Según…
Por qué importaKimi K3 representa un avance competitivo importante del ecosistema de IA chino, demostrando capacidad para rivalizar con modelos occidentales líderes…
Anthropic lanza Claude Fable 5, su primer modelo de clase Mythos
Anthropic ha anunciado Claude Fable 5, descrito como el modelo más potente que ha puesto a disposición pública. El modelo destaca en ingeniería de software…
Por qué importaRepresenta un punto de inflexión en la disponibilidad de capacidades avanzadas: modelos de clase frontera ahora accesibles públicamente tras superar…
Google DeepMind presenta Gemma 4 12B: modelo multimodal sin codificadores para portátiles
Google DeepMind ha lanzado Gemma 4 12B, un modelo multimodal diseñado para ejecutarse localmente en portátiles con 16GB de RAM. El modelo adopta una…
Por qué importaDemocratiza la IA multimodal avanzada llevándola a dispositivos de consumo sin dependencia de servidores en la nube, reduciendo latencia y costes…
Google DeepMind transforma el puntero del ratón en asistente de IA contextual
Google DeepMind ha desarrollado un puntero del ratón impulsado por inteligencia artificial que comprende el contexto visual y semántico de lo que señala…
Por qué importaRepresenta un cambio fundamental en cómo interactuamos con la IA: del usuario adaptándose a la máquina (escribir prompts detallados) a la máquina…
Gemma 4 VLA se ejecuta en Jetson Orin Nano Super con visión multimodal
NVIDIA ha publicado un tutorial demostrando cómo ejecutar Gemma 4, un modelo de agente visual de lenguaje (VLA), en hardware de bajo consumo Jetson Orin Nano…
Por qué importaDemuestra que los agentes multimodales sofisticados pueden ejecutarse de forma eficiente en dispositivos edge con restricciones severas de memoria y…
HoloTab: extensión de Chrome para automatizar tareas web con agentes IA
HCompany lanzó HoloTab, una extensión de Chrome basada en su modelo Holo3 de visión y comprensión de interfaces. El agente automatiza tareas web sin necesidad…
Por qué importaDemocratiza el acceso a agentes de automatización web que antes requerían programación o equipos técnicos dedicados. Es el primer caso de uso masivo…
Meta lanza Muse Spark, su modelo más potente, integrado en WhatsApp, Instagram y gafas AI
Meta ha presentado Muse Spark, el primer modelo de la nueva serie Muse de Meta Superintelligence Labs, descrito como su modelo más potente hasta la fecha. El…
Por qué importaEste es el primer modelo de una nueva serie arquitectónica de Meta diseñada según un enfoque de escalado científico. Su integración sistemática en…
Falcon Perception: modelo multimodal eficiente de visión y lenguaje del TII
El Technology Innovation Institute (TII) ha lanzado Falcon Perception, un modelo multimodal de 0,6B parámetros que procesa imágenes y texto en un único…
Por qué importaDemuestra que un diseño unificado early-fusion es viable y eficiente para tareas densas de percepción visual con texto, reduciendo complejidad frente…
OpenAI lanza GPT-5.4 mini y nano para tareas de baja latencia con costes reducidos
OpenAI ha lanzado dos nuevos modelos de tamaño reducido: GPT-5.4 mini y GPT-5.4 nano. GPT-5.4 mini incluye capacidades multimodales, búsqueda web y uso de…
Por qué importaEstos modelos ofrecen a desarrolladores y empresas una opción económicamente viable para desplegar IA moderna en producción sin el coste prohibitivo…
Apple adquiere Q.ai por casi 2.000 millones para potenciar audio e IA en dispositivos
Apple ha adquirido Q.ai, una startup israelí especializada en tecnologías de audio e imágenes basadas en machine learning, por un valor de aproximadamente…
Por qué importaEsta es la segunda mayor adquisición de Apple en su historia y refleja su estrategia de integrar IA avanzada en hardware, especialmente en audio y…
Japón desarrolla robots de cuidado de ancianos con tecnología NVIDIA en proyecto de investigación
La Agencia de Ciencia y Tecnología de Japón, con tecnologías de NVIDIA, está desarrollando robots autónomos para atención de ancianos como parte de su…
Por qué importaLa robótica de cuidado de ancianos es un caso de uso crítico en sociedades envejecidas como Japón, demostrando cómo la IA y la simulación robotizada…
Sony patenta Ghost Player, sistema IA que juega videojuegos por ti
Sony ha registrado una patente llamada Ghost Player ante la Organización Mundial de la Propiedad Intelectual que permite a la IA tomar el control del mando en…
Por qué importaRepresenta una estrategia de diseño en videojuegos que busca reducir la frustración mediante automatización de retos, comparable a las funciones de…
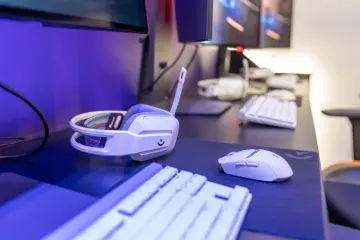
Razer presenta productos IA para gaming: avatar entrenador y auriculares con visión en tiempo real
Razer reveló en el CES 2026 más de seis productos impulsados por inteligencia artificial. Destacan Project AVA, un avatar animado de 5,5 pulgadas que actúa…
Por qué importaRazer materializa la integración de IA en accesorios gaming de consumo masivo, demostrando que la IA ya no es solo backend sino interfaz de…
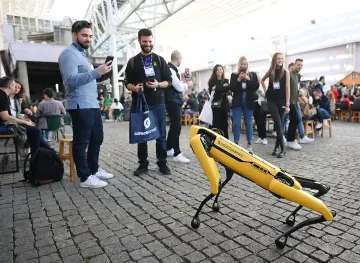
Google integra Gemini en robots humanoides de Boston Dynamics para fábricas
Google DeepMind y Boston Dynamics anunciaron en CES 2026 la integración de Gemini, el modelo de IA multimodal de Google, en robots humanoides como Atlas y en…
Por qué importaMarca un punto de inflexión en la automatización industrial: dota a robots humanoides de inteligencia visual y contextual para realizar tareas…
RoboCat: agente automejorable de DeepMind que aprende tareas robóticas con pocos datos
Google DeepMind presenta RoboCat, un agente de IA basado en el modelo multimodal Gato que aprende a realizar múltiples tareas en diferentes brazos robóticos…
Por qué importaReduce significativamente la barrera de datos etiquetados en robótica, que es el principal cuello de botella en el desarrollo de robots multiusos. La…
DeepMind presenta Perception Test, benchmark multimodal para evaluar percepción en IA
Google DeepMind ha lanzado el Perception Test, un benchmark basado en videos reales del mundo para evaluar las capacidades perceptivas de modelos de IA…
Por qué importaLos benchmarks son instrumentos clave para definir objetivos de investigación y medir progreso en IA. El Perception Test aborda una brecha…