Tecnología
datos sintéticos
Los datos sintéticos son información generada artificialmente, mediante modelos de IA o simulación, para entrenar o validar otros sistemas de IA cuando los datos reales son escasos, costosos o sensibles. Se usan ya en lenguaje, visión, robótica, voz y dominios especializados como construcción o salud.
Sobre esta tecnología, IA para hoy ha analizado 17 noticias, procedentes de 7 medios distintos. En los últimos siete días han sido 2. La fiabilidad media de esa cobertura es de 3,5 sobre 5, medida con las reglas de nuestro método. Las áreas de impacto que más se repiten son Desarrollo, IT, Automatización. Aparece en 8 historias en seguimiento.
Evolución en 16 semanas
El momentum semanal se estima con la misma fórmula que el momentum actual: volumen, aceleración respecto a la semana anterior, diversidad de fuentes e impacto.
Análisis Qué significa para una empresa
- Oportunidades
- Permite entrenar modelos en dominios con pocos datos reales (nicho industrial, salud, robótica), reducir costes de anotación manual y evitar riesgos legales o de seguridad al no usar datos reales sensibles de clientes o entornos peligrosos. También abre nuevos modelos de negocio de 'datos como servicio' y plataformas de simulación.
- Riesgos
- Riesgo de sesgos o falta de realismo si la generación sintética no se valida bien, dependencia de proveedores como NVIDIA o Snorkel para pipelines clave, y cuestiones de propiedad y gobernanza cuando se compran datos internos de startups cerradas para entrenar modelos de terceros.
- Qué debería hacer una empresa
- Evaluar en los próximos 6-18 meses el uso de datos sintéticos para acelerar el entrenamiento o ajuste de modelos propios en dominios donde los datos reales sean escasos o sensibles, priorizando proveedores con validación de calidad demostrada.
Análisis generado por IA a partir de las noticias disponibles; actualizado 18 oct.
Relacionadas
Nvidia ×8LLM ×7agentes ×5robótica ×3OpenAI ×2Google ×2Hugging Face ×2Amazon ×2IA física ×2voz ×2
Historias
NVIDIA actualiza Cosmos para modelos del mundo y IA física
NVIDIA y proyectos europeos de IA en el sector público
NVIDIA y AI4Bharat publican un corpus de 2,8 billones de tokens para idiomas indios
Venta de datos de startups cerradas para entrenar IA
ServiceNow presenta AutoSynthData para entrenar agentes de IA empresariales
AMD compra World Labs, de Fei-Fei Li, por 8.200 millones
MIT desarrolla xvr, IA para guiar instrumentos en cirugías mínimamente invasivas
Snorkel AI triplica valoración tras ronda de 350 millones
Noticias
NVIDIA amplía Cosmos con herramientas para entrenar, evaluar y desplegar modelos del mundo
NVIDIA ha ampliado su plataforma Cosmos con nuevas herramientas de entrenamiento, checkpoints de simulación y plantillas de Cosmos Data Factory para…
Por qué importaLos modelos del mundo son clave para robótica, vehículos autónomos e inspección industrial, donde generar datos sintéticos puede reducir pruebas…
NVIDIA y socios europeos despliegan modelos abiertos en proyectos del sector público
NVIDIA publicó en su blog varios proyectos del sector público europeo que usan modelos abiertos. En Polonia, el eHealth Centre desarrolla una plataforma de…
Por qué importaMuestra cómo las administraciones europeas buscan modelos que puedan evaluar, adaptar y ejecutar en infraestructura propia para mantener el control…
NVIDIA y AI4Bharat presentan Nemotron-pretraining-Indic-v1, con 2,8 billones de tokens en 22 idiomas indios
NVIDIA, con IIT Madras y su laboratorio AI4Bharat, anuncia Nemotron-pretraining-Indic-v1, un corpus de unos 2,8 billones de tokens en los 22 idiomas listados…
Por qué importaLos idiomas indios cuentan con poco material de entrenamiento, y un corpus abierto y auditable reduce esa barrera para crear modelos en esas lenguas…
Startups fallidas venden sus datos internos a laboratorios de IA para entrenar modelos
Empresas emergentes que cierran están vendiendo su código y datos de trabajo (correos, chats, documentos) a laboratorios de IA, a través de intermediarios como…
Por qué importaLos datos internos de empresas cerradas se están convirtiendo en un activo negociable para entrenar IA, con dudas sobre privacidad, propiedad y…
ServiceNow presenta AutoSynthData, sistema para generar datos de entrenamiento de agentes empresariales
ServiceNow CoreAI publicó AutoSynthData, un método para generar y validar tareas de entrenamiento que exponen las debilidades de un modelo agente en un entorno…
Por qué importaPermite a las empresas personalizar agentes de IA para sus propios sistemas y flujos de trabajo en lugar de depender solo de modelos genéricos…
AMD adquiere World Labs, de Fei-Fei Li, por 8.200 millones de dólares
AMD anunció la adquisición de World Labs, startup de modelos de mundo fundada por Fei-Fei Li, por 8.200 millones de dólares. Li se incorporará a AMD como…
Por qué importaEs una apuesta estratégica de AMD para competir con Nvidia en el ecosistema de chips e IA para robótica y simulación física, integrando investigación…
El MIT desarrolla xvr, una IA que guía instrumentos quirúrgicos en tiempo real con precisión submilimétrica
Investigadores del MIT presentaron xvr, un sistema de IA que vincula radiografías 2D tomadas durante cirugías con estudios 3D previos del paciente para ubicar…
Por qué importaReduce el tiempo de calibración de navegación quirúrgica de horas a minutos, lo que podría ampliar el acceso a procedimientos mínimamente invasivos…
Snorkel AI triplica su valoración a 3.500 millones de dólares por auge de datos de entrenamiento para IA
Snorkel AI cerró una Serie E de 350 millones de dólares liderada por Insight Partners y S32, alcanzando una valoración de 3.500 millones, casi el triple de los…
Por qué importaConfirma que la demanda de datos de entrenamiento de alta calidad y entornos de RL sigue siendo un cuello de botella crítico para los laboratorios de…
TypeSafe AI lanza Jev, modelo no lingüístico que predice probabilidades para automatización de software
TypeSafe AI, startup fundada por un exinvestigador de OpenAI coinventor de RLHF, lanzó Jev, un modelo basado en transformers que no genera texto sino…
Por qué importaOfrece una alternativa mucho más barata y rápida que los LLM para tareas de automatización y clasificación donde no se necesita generación de…
AWS usa datos sintéticos con SageMaker y Rekognition para mejorar la detección de personas en entornos industriales peligrosos
AWS describe un pipeline que usa el modelo de difusión Qwen-Image-Edit-2509 en SageMaker AI para insertar personas sintéticas en imágenes reales de maquinaria…
Por qué importaOfrece una vía práctica para entrenar modelos de seguridad industrial en escenarios raros y peligrosos que son costosos y arriesgados de recopilar en…
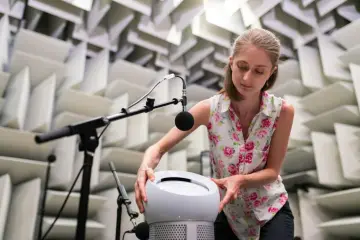
Treble, startup islandesa de simulación acústica para IA de voz, capta 18 millones de dólares
Treble, startup islandesa fundada en 2020, ha recaudado 18 millones de dólares en una extensión de su Serie A liderada por Paladin Capital Group, superando los…
Por qué importaEl caso ilustra cómo la infraestructura de datos y testing especializado (aquí, física acústica simulada) se está convirtiendo en un cuello de…
Salesforce lanza Koa, su primer modelo de razonamiento propio construido con Nemotron de Nvidia
Salesforce presentó Koa, su primer modelo de razonamiento propio, construido sobre el modelo abierto Nemotron de Nvidia y post-entrenado por ambas empresas…
Por qué importaMuestra cómo grandes empresas de software empresarial buscan reducir su dependencia de los laboratorios de IA de frontera desarrollando modelos…
ONESTRUCTION desarrolla modelo especializado Ishigaki-IDS para flujos BIM con AWS
ONESTRUCTION, con asesoría técnica de AWS Generative AI Innovation Center, desarrolló Ishigaki-IDS, un modelo fundacional especializado en flujos de…
Por qué importaDemuestra un patrón replicable para construir modelos especializados en dominios con datos escasos mediante síntesis de datos y optimización…
NVIDIA abre datos sintéticos para entrenar agentes de IA con 10 billones de tokens
NVIDIA ha publicado más de 10 billones de tokens de preentrenamiento y millones de muestras de post-entrenamiento como parte de Nemotron, incluyendo el…
Por qué importaLa liberación de datos sintéticos de alta calidad reduce la barrera para construir agentes de IA confiables sin exponer datos corporativos sensibles…
Google Research presenta Simula, framework de generación de datos sintéticos por diseño de mecanismos
Google Research publicó un paper sobre Simula, un framework que trata la generación de datos sintéticos como un problema de diseño de mecanismos a nivel de…
Por qué importaLa escasez de datos reales en dominios especializados o sensibles a la privacidad es un cuello de botella clave para especializar modelos de IA en…
NVIDIA amplía plataforma Isaac para desarrollo acelerado de robots con IA
NVIDIA ha anunciado nuevas herramientas y modelos abiertos en su plataforma Isaac para acelerar el desarrollo de robots autónomos. La actualización incluye…
Por qué importaLas herramientas anunciadas reducen significativamente el tiempo y coste de desarrollo de robots autónomos al permitir generar datos sintéticos (que…
ABB Robotics integra NVIDIA Omniverse para cerrar brecha simulación-realidad en robots
ABB Robotics y NVIDIA anunciaron una asociación para integrar las bibliotecas de NVIDIA Omniverse en RobotStudio, la suite de programación y simulación de ABB…
Por qué importaEsta integración aborda un problema fundamental en automatización industrial: la brecha entre el entrenamiento virtual y el despliegue real de…