Tecnología
LLM multimodal
Los LLM multimodales son modelos de inteligencia artificial capaces de procesar y generar contenido combinando texto, imagen, audio y video en una sola arquitectura. Permiten aplicaciones que van desde robots que interpretan su entorno hasta análisis de documentos clínicos o imágenes médicas complejas.
Sobre esta tecnología, IA para hoy ha analizado 11 noticias, procedentes de 6 medios distintos. No ha habido cobertura nueva en la última semana. La fiabilidad media de esa cobertura es de 4,6 sobre 5, medida con las reglas de nuestro método. Las áreas de impacto que más se repiten son Desarrollo, Automatización, Operaciones. Aparece en 8 historias en seguimiento.
Evolución en 16 semanas
El momentum semanal se estima con la misma fórmula que el momentum actual: volumen, aceleración respecto a la semana anterior, diversidad de fuentes e impacto.
Análisis Qué significa para una empresa
- Oportunidades
- Permiten automatizar procesos que combinan distintos tipos de datos (documentos, imágenes, voz) reduciendo errores y costes operativos, como muestra el caso de Guardoc en salud. También abren nuevos productos en robótica, diagnóstico médico y generación de contenido audiovisual personalizado.
- Riesgos
- El uso indebido puede generar contenido dañino o ilegal, como muestra la investigación de Ofcom a X por imágenes sexualizadas generadas con Grok, exponiendo a las empresas a sanciones regulatorias severas. También existe dependencia de proveedores concretos (Google, AWS) y riesgo de errores en dominios críticos como el médico si no hay supervisión humana.
- Qué debería hacer una empresa
- Las empresas deberían evaluar en los próximos 6 meses casos de uso concretos en documentación y atención al cliente donde la multimodalidad reduzca costes, estableciendo desde el inicio controles de moderación de contenido y cumplimiento normativo.
Análisis generado por IA a partir de las noticias disponibles; actualizado 13 sep.
Relacionadas
Google DeepMind ×3Google ×2robótica ×2RAG ×2visión por computadora ×2Anthropic ×1AWS ×1Amazon ×1Amazon Web Services ×1xAI ×1
Historias
CES 2026: IA física y robótica humanoide como nuevo centro de gravedad tecnológico
Google impulsa robótica con Gemini Robotics 2/ER 2 y modelos Gemini optimizados
Guardoc reduce errores documentales sanitarios con modelos Nova de AWS
Smartsheet y AWS impulsan agentes IA con Model Context Protocol
Google amplía Google Vids con avatares personalizados y edición multimodal
X y Grok bajo investigación por deepfakes sexuales no consentidos
IA en automatización de descubrimiento farmacéutico para enfermedades raras
Google: extracción de intenciones con modelos pequeños en dispositivos
Noticias
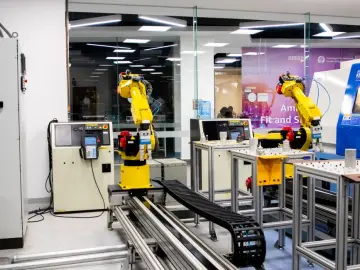
Google DeepMind presenta Gemini Robotics 2 con control corporal completo y colaboración multirobótica
Google DeepMind ha lanzado Gemini Robotics 2, un sistema que añade control de cuerpo completo, destreza avanzada y colaboración entre múltiples robots a la…
Por qué importaRepresenta un salto cualitativo hacia robots generales y adaptables que pueden razonar, no solo ejecutar secuencias predefinidas. La capacidad de…
Guardoc reduce errores médicos 46% usando modelos Nova de AWS en documentación clínica
Guardoc Health utiliza los modelos Amazon Nova a través de Amazon Bedrock para procesar y clasificar documentación clínica en centros de cuidados a largo…
Por qué importaLas organizaciones sanitarias gastan cientos de millones anuales en procesamiento manual de documentos, y los errores de documentación generan…
Google añade avatares personalizados de IA a Vids para crear videos con tu apariencia
Google anunció nuevas funciones para Google Vids que incluyen avatares digitales personalizados basados en selfies y grabaciones de voz del usuario…
Por qué importaGoogle transforma Google Vids de una herramienta de presentación corporativa asistida por IA en una plataforma completa de creación de video que…
AWS lanza servidor MCP de visión para agentes IA con integración estandarizada
AWS ha publicado un Computer Vision MCP Server que integra visión por computadora, agentes y el Model Context Protocol para permitir que los sistemas de IA…
Por qué importaEsta arquitectura reduce significativamente la complejidad de integración para desarrolladores, permitiendo construir pipelines de análisis visual…
IA acelera descubrimiento de fármacos para enfermedades raras ante escasez de talento
Insilico Medicine y GenEditBio presentaron en Web Summit Qatar cómo la IA automatiza tareas de descubrimiento farmacéutico y edición génica para abordar miles…
Por qué importaLa automatización de fases críticas del descubrimiento farmacéutico puede multiplicar la capacidad de investigación y acelerar la llegada de…
Google demuestra modelos pequeños en extracción de intenciones de usuario en dispositivos
Google Research presenta un método que permite a modelos multimodales pequeños entender intenciones de usuario desde trayectorias de interacción en UI (web y…
Por qué importaPermite ejecutar comprensión de intenciones en dispositivos sin enviar datos a servidores, reduciendo latencia, costes y riesgos de privacidad. Es…
Google lanza MedGemma 1.5 y MedASR para interpretación médica con soporte de imágenes 3D
Google Research ha actualizado MedGemma a versión 1.5 con capacidad mejorada para interpretar imágenes médicas de alta dimensionalidad (tomografías…
Por qué importaEstas herramientas cierran la brecha entre documentación médica verbal, imagenología compleja y razonamiento clínico en un flujo integrado…
Ofcom investiga a X por generación de imágenes sexualizadas con Grok
Ofcom, el regulador de comunicaciones del Reino Unido, ha abierto una investigación formal contra X por posibles violaciones de la Online Safety Act…
Por qué importaEste caso marca el primer punto de quiebre regulatorio serio contra una capacidad de generación de imágenes de IA en una economía importante…
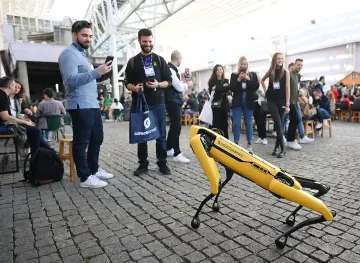
Google integra Gemini en robots humanoides de Boston Dynamics para fábricas
Google DeepMind y Boston Dynamics anunciaron en CES 2026 la integración de Gemini, el modelo de IA multimodal de Google, en robots humanoides como Atlas y en…
Por qué importaMarca un punto de inflexión en la automatización industrial: dota a robots humanoides de inteligencia visual y contextual para realizar tareas…
Google DeepMind presenta Lyria, modelo de generación de música con voces de artistas reales
Google DeepMind ha anunciado Lyria, su modelo más avanzado de generación de música, capaz de crear instrumentales, vocales y mantener continuidad musical en…
Por qué importaEste lanzamiento marca un hito en la generación de contenido creativo con IA, demostrando que sistemas automáticos pueden mantener coherencia musical…
Google DeepMind revela que la atención cruzada entre modalidades es clave en transformers multimodales
Google DeepMind publica un análisis de qué componentes determinan el éxito de los transformers multimodales (que procesan simultáneamente texto e imagen). El…
Por qué importaComprensión de qué hace funcionar realmente los modelos multimodales es esencial para diseñar arquitecturas más eficientes y económicas. Este…