DeepMind: agentes IA aprenden conductas económicas como producción, comercio y fijación de precios
Hecho Qué ha ocurrido
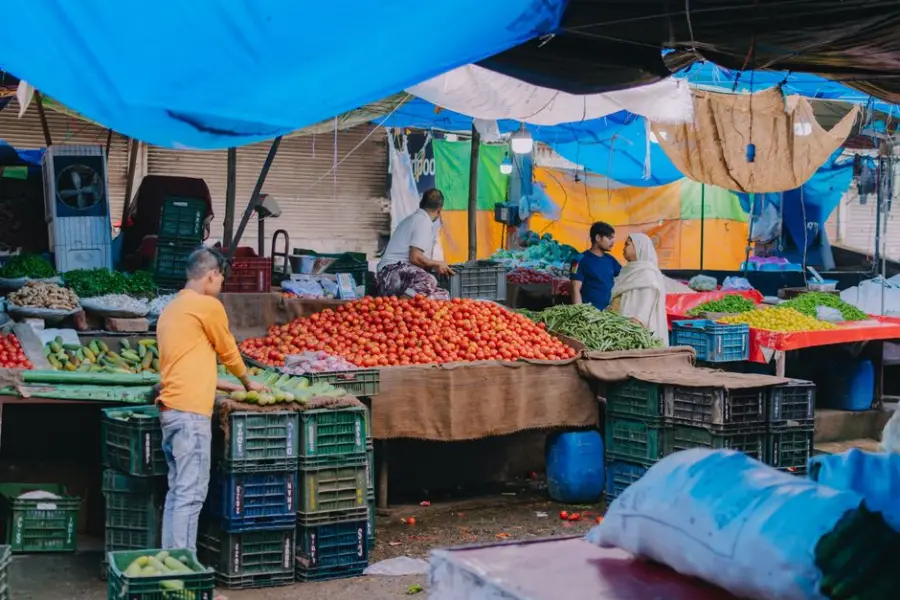
DeepMind publica un paper que demuestra que agentes de aprendizaje por refuerzo profundo pueden aprender comportamientos microeconómicos como producción, consumo y comercio de bienes. En un entorno simulado llamado Fruit Market, los agentes aprenden a tomar decisiones económicamente racionales sobre precios, reaccionan a cambios en oferta y demanda, y algunos desarrollan comportamiento de arbitraje transportando bienes entre regiones con precios distintos. El trabajo introduce nuevas competencias sociales para agentes multiagente y será incluido en la próxima versión de Melting Pot.
Resumen generado mediante IA a partir de Google DeepMind (original en inglés). Naturaleza de la información: hecho documentado.
Análisis Por qué importa
Representa un avance en inteligencia multiagente hacia simular comportamientos económicos reales sin codificar conocimiento de dominio. Demuestra que la IA puede aprender negociación, especialización y trading de forma emergente, habilidades relevantes para sistemas autónomos en economías simuladas y eventualmente para aplicaciones de coordinación en sistemas complejos.
- Quién se ve afectado
- Investigadores en aprendizaje por refuerzo multiagente, economía computacional, y equipos de IA que trabajan en simulaciones y modelado de sistemas complejos.
- Qué puede cambiar
- Amplia el alcance de multiagente RL desde juegos y coordinación hacia fenómenos económicos. Potencialmente permite usar agentes IA para simular y predecir dinámicas económicas sin supuestos fijos, facilitando investigación en economía y diseño de mecanismos.
Análisis generado a partir de la información disponible; no procede de la fuente.
Predicción Qué observar a continuación
Adopción del entorno Fruit Market por la comunidad investigadora. Extensiones hacia negociación más compleja, información asimétrica o restricciones realistas. Uso de estas técnicas en sistemas de simulación económica o diseño de mercados digitales.
Enviar esta noticia por correo
Enviado. Revisa que llegue a la bandeja de entrada de quien lo reciba.
La dirección no parece válida.
Has enviado varios correos seguidos. Espera un rato.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
No se ha podido enviar. Inténtalo de nuevo en unos minutos.
Fuente original: Google DeepMind (fuente primaria). La referencia es siempre el artículo original.
Ver fuente original ↗aprendizaje por refuerzo profundoagentes multiagentesimulación económica Google DeepMind agentes multiagente aprendizaje por refuerzo DeepMind economía computacional Melting Pot
Relacionadas
DeepMind logra que agentes de IA aprendan comportamientos complejos observando demostraciones
Google DeepMind ha desarrollado agentes de inteligencia artificial capaces de transferencia cultural en tiempo real mediante aprendizaje por refuerzo profundo…
Por qué importaEste avance abre la posibilidad de que sistemas de IA aprendan de manera flexible y rápida a partir de observaciones, sin requerir grandes conjuntos…
Google DeepMind demuestra RL para diseño de políticas económicas alineadas con valores humanos
Google DeepMind publicó en Nature Human Behaviour un estudio en el que entrena un agente de aprendizaje por refuerzo profundo para diseñar políticas de…
Por qué importaEl trabajo aborda directamente el reto de alineación de valores en sistemas de IA, demostrando que el aprendizaje reforzado puede encontrar…
Google DeepMind estudia cómo agentes de RL aprenden normas sociales y cumplimiento
Google DeepMind publica un paper de investigación que utiliza aprendizaje por refuerzo profundo multi-agente para modelar la formación de normas sociales y el…
Por qué importaEl trabajo abre un enfoque alternativo a la teoría de juegos para modelar sistemas socio-ecológicos complejos donde las interacciones no se reducen a…
DeepMind presenta agentes IA que imaginan y planifican acciones futuras
Google DeepMind ha publicado dos papers sobre arquitecturas de agentes basadas en 'imaginación': redes neuronales que internamente simulan consecuencias de…
Por qué importaEsta investigación avanza en el razonamiento deliberativo de agentes IA, permitiéndoles funcionar con modelos imperfectos y adaptar estrategias de…
Tu opinión
Te hemos enviado un correo para confirmar tu dirección. El comentario se procesará cuando pulses el enlace.
Gracias. Tu comentario se publicará cuando lo revise el equipo (los primeros comentarios de cada persona se moderan).
Comentario publicado. Gracias por participar.
No se puede comentar aquí.
Indica un nombre (de 2 a 60 caracteres).
El correo no parece válido.
El comentario debe tener entre 10 y 2.000 caracteres.
Demasiados enlaces en el comentario.
No se ha podido comprobar que no eres un robot. Vuelve a intentarlo.
Has alcanzado el límite diario de comentarios.
Demasiados comentarios seguidos. Espera un rato.
No se ha podido enviar el correo de confirmación. Inténtalo de nuevo en unos minutos.