Tecnología
aprendizaje por refuerzo profundo
El aprendizaje por refuerzo profundo es una técnica de IA en la que un agente aprende a tomar decisiones mediante prueba y error, optimizando una recompensa a largo plazo. Se ha usado para dominar juegos complejos, controlar sistemas físicos como el plasma de fusión y modelar comportamientos económicos o sociales en simulaciones.
Sobre esta tecnología, IA para hoy ha analizado 8 noticias, procedentes de 1 medio distinto. No ha habido cobertura nueva en la última semana. La fiabilidad media de esa cobertura es de 5,0 sobre 5, medida con las reglas de nuestro método. Las áreas de impacto que más se repiten son Desarrollo, Operaciones, Automatización. Aparece en 8 historias en seguimiento.
Análisis Qué significa para una empresa
- Oportunidades
- Permite automatizar el control de procesos complejos y dinámicos, optimizar sistemas donde no hay reglas explícitas, y simular escenarios económicos o de negociación para apoyar decisiones estratégicas.
- Riesgos
- Requiere grandes recursos computacionales y datos de simulación de alta fidelidad, su comportamiento puede ser difícil de interpretar y auditar, y su aplicación fuera de entornos simulados o de laboratorio sigue siendo limitada y costosa.
- Qué debería hacer una empresa
- Las empresas con procesos industriales o de control complejo pueden explorar pilotos con proveedores especializados en un plazo de 18-36 meses, pero no es prioritario para la mayoría de organizaciones no técnicas.
Análisis generado por IA a partir de las noticias disponibles; actualizado 13 sep.
Relacionadas
Google DeepMind ×6redes neuronales recurrentes ×2agentes ×1simulación ×1agentes autónomos ×1teoría de juegos ×1agentes multiagente ×1transferencia de conocimiento ×1meta-learning ×1JAX ×1
Historias
DeepMind domina Stratego con DeepNash y teoría de juegos
DeepMind: emergencia de comportamiento económico en agentes multiagente
DeepMind: transferencia cultural sin datos humanos en agentes de RL
DeepMind controla plasma tokamak con aprendizaje por refuerzo
DeepMind desarrolla herramientas para evaluar cooperación en IA multiagente
Agent57 supera nivel humano en todos los juegos Atari
DeepMind: meta-aprendizaje por refuerzo como mecanismo de la corteza prefrontal
DeepMind y navegación con redes neuronales inspiradas en el cerebro
Noticias
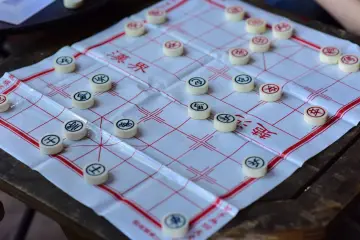
DeepMind presenta DeepNash, IA que domina Stratego, juego de información imperfecta
Google DeepMind ha desarrollado DeepNash, un agente de IA que ha alcanzado nivel de experto humano en Stratego, un juego de mesa más complejo que el ajedrez y…
Por qué importaEste avance es significativo porque Stratego representa un desafío técnico diferente a juegos de información perfecta como el ajedrez o el Go…
DeepMind: agentes IA aprenden conductas económicas como producción, comercio y fijación de precios
DeepMind publica un paper que demuestra que agentes de aprendizaje por refuerzo profundo pueden aprender comportamientos microeconómicos como producción…
Por qué importaRepresenta un avance en inteligencia multiagente hacia simular comportamientos económicos reales sin codificar conocimiento de dominio. Demuestra que…
DeepMind logra que agentes de IA aprendan comportamientos complejos observando demostraciones
Google DeepMind ha desarrollado agentes de inteligencia artificial capaces de transferencia cultural en tiempo real mediante aprendizaje por refuerzo profundo…
Por qué importaEste avance abre la posibilidad de que sistemas de IA aprendan de manera flexible y rápida a partir de observaciones, sin requerir grandes conjuntos…
Google DeepMind controla plasma de fusión con aprendizaje por refuerzo profundo
Google DeepMind colaboró con el Swiss Plasma Center de EPFL para desarrollar un sistema de aprendizaje por refuerzo profundo capaz de controlar autónomamente…
Por qué importaEste logro demuestra que el aprendizaje automático puede acelerar significativamente la investigación en fusión nuclear, uno de los mayores desafíos…
Agent57: primer agente de refuerzo profundo que supera nivel humano en todos los juegos Atari
DeepMind ha desarrollado Agent57, el primer agente de aprendizaje por refuerzo profundo que obtiene puntuaciones superiores al nivel humano en los 57 juegos de…
Por qué importaRepresenta un hito significativo en la generalización de agentes de RL: demuestra que es posible entrenar un único sistema capaz de adaptarse a…
DeepMind demuestra que la corteza prefrontal actúa como sistema de aprendizaje por refuerzo metacognitivo
Google DeepMind publica un estudio en Nature Neuroscience que propone que la corteza prefrontal del cerebro funciona bajo principios de meta-aprendizaje por…
Por qué importaEste hallazgo cierra la brecha entre neurociencia e IA, demostrando que principios de meta-aprendizaje desarrollados en IA explican mecanismos…
DeepMind demuestra que redes neuronales desarrollan representaciones de cuadrícula para navegar
Google DeepMind ha publicado un artículo en Nature en el que entrenó redes neuronales recurrentes para navegar en entornos virtuales y descubrió que…
Por qué importaEl hallazgo valida una hipótesis neurocientífica de más de una década sobre la función computacional de las células de cuadrícula del cerebro, pero…
DeepMind estudia cooperación multiagente mediante dilemas sociales secuenciales
Google DeepMind ha publicado una investigación sobre cómo los agentes de IA aprenden a cooperar o competir usando aprendizaje por refuerzo profundo…
Por qué importaEntender cómo los agentes de IA deciden cooperar o defeccionar es fundamental para controlar sistemas multiagente en aplicaciones reales. Este…